
SERP-Evidenz, Wettbewerbsprüfung und Position Tracking verbinden
Nutze die Definitionen der Keyword-Metriken, um einzuordnen, was eine Momentaufnahme der Suchergebnisse erklären kann.
Eine datierte SERP-Beobachtung
Wettbewerbsevidenz in Schichten
Eine kontrollierte Messreihe
Wähle die Evidenzschicht vor der Datenanfrage
SERP-Evidenz, Wettbewerbsinformationen und Position Tracking beantworten unterschiedliche Fragen. Ein angefragter SERP-Snapshot hält fest, was für ein Keyword in einem definierten Suchkontext erschien. Wettbewerbsoberflächen fassen Domains zusammen und ergänzen auf ausdrückliche Anfrage Domain- oder Ranking-Keyword-Daten. Tracking wiederholt eine kontrollierte Messung nach Zeitplan und führt ein Laufprotokoll.
Die Schichten können aufeinander aufbauen, ohne zum selben Datensatz zu werden. Ein aktueller Snapshot kann eine Ranking-Domain zeigen, der Wettbewerbskatalog kann sie für die Prüfung erhalten und Tracking kann später die eigene Domain für ein freigegebenes Set messen. Scope, Datum, Kostenpfad und fehlende Zustände bleiben getrennt.
| Frage | Passende Oberfläche |
|---|---|
| Was zeigt die Ergebnisseite jetzt? | Einmalige SERP-Anfrage |
| Welche Domains tauchen in der Workspace-Evidenz wiederholt auf? | Wettbewerbskatalog und SERP-Überschneidung |
| Welche breitere organische oder bezahlte Präsenz hat eine Domain? | Angefragtes Domain-Profil oder Tiefenanalyse |
| Wie verändert sich unsere Position in einem festen Kontext? | Position-Tracking-Zeitplan |
| Ist die Anfrage gelaufen, abgeschlossen, fehlgeschlagen oder abgerechnet? | Activity und Tracking-Laufprotokoll |
Fordere eine SERP an, wenn das Ergebnisfeld die Entscheidung verändern kann
Eine einmalige SERP-Anfrage passt, wenn du beobachtete Top-Ergebnisse, unterstützte Ergebnisfeatures, die Position der konfigurierten Domain, Ranking-URLs oder eine datierte Basis für Wettbewerbsüberschneidungen brauchst. Für eine geprüfte Shortlist ist sie aussagekräftiger als für einen ungeprüften Bestand mit noch unklarer Relevanz.
Die Anfrage ist bezahlte externe Arbeit. Bestätige normalisierte Keywords, Standort, Sprache, Erhebungsmodus, noch fehlende Zeilen, Cache-Treffer, Schätzung und Balance. Die Oberfläche kann große Auswahlen in begrenzten Paketen verarbeiten. Eine technisch angenommene Anfrage beweist trotzdem nicht, dass jedes Keyword Daten geliefert hat.
- Beginne mit Zeilen, bei denen Ergebnistypen oder Ranking-Seiten die Seitenentscheidung beeinflussen.
- Nutze Nur fehlende Daten, wenn die Auswahl vollständige und unvollständige Zeilen mischt.
- Frische Cache-Zeilen werden übersprungen, solange du keinen Ersatz erzwingst.
- Ein erzwungener Refresh kann Balance verbrauchen, ohne eine Entscheidung materiell zu verändern.
- Prüfe nach dem Lauf angefragte, abgeschlossene, datenlose, fehlgeschlagene und gecachte Mengen.
Wähle den Liefermodus nach Frist und Evidenzbedarf
Live, Priority und Standard können die aktuellen SERP-Felder liefern, unterscheiden sich aber bei Lieferzeit und geschätzten Kosten. Historical fordert monatliche Beobachtungen für 3, 6, 9 oder 12 Monate an und schreibt Positionshistorie. Ein alter Ergebnisstand wird dabei nicht als aktuelle SERP ausgegeben.
Lies die aktuelle Schätzung in der Bestätigung, weil Preise, ausgewählte Zeilen, Cache-Wiederverwendung und historischer Zeitraum die Reservierung verändern. Live ist nicht genauer, nur weil es schneller ist. Standard ist nicht veraltet, nur weil eine asynchrone Anbieter-Queue verwendet wird. Historische Beobachtungen brauchen beim Vergleich mit aktuellen Snapshots ihr eigenes Datum.
| Modus | Geeignet, wenn |
|---|---|
| Live | Das aktuelle Ergebnis in der laufenden Prüfung benötigt wird |
| Priority | Ein schnelleres Queue-Ergebnis den angezeigten Aufpreis rechtfertigt |
| Standard | Kosten wichtiger sind als sofortige Lieferung |
| Historical | Eine datierte Positionsreihe wertvoller ist als ein weiterer aktueller Snapshot |
SERP-Features beschreibt erkannte Module eines angefragten Snapshots
Das Feld kann unterstützte Module wie AI Overview, Featured Snippet, People Also Ask, Local Pack, Bilder, Videos, Shopping, Knowledge Panel, Site Links, Top Stories, Social Packs, Jobs und FAQ-Markup erfassen. Diese Flags sind gezielt angefragte SERP-Daten. Sie werden nicht automatisch für jedes Keyword der Datenbank erhoben.
Ein Flag bedeutet, dass das Modul zu diesem Zeitpunkt in Markt, Sprache, Gerät und Erhebungskontext erkannt wurde. Es beweist weder den Besitz durch deine Domain noch eine bestimmte Klickwirkung. Features können wandern oder verschwinden. Prüfe Snapshot und Datum, bevor du eine Seite änderst oder Klickpotenzial prognostizierst.
Wechsle für den Vergleich ganzer Domains mit einer klaren Vergleichsfrage zur Wettbewerbsanalyse.
Lies die beobachteten Top-Ergebnisse, bevor du eine Ursache zuweist
Die Top-Ergebnisse können Ranking-Domains, URLs, Positionen sowie verfügbaren Link- und Feature-Kontext zeigen. Vergleiche damit Seitentypen, Suchaufgaben, wiederkehrende Domains und die Präsenz deiner eigenen Domain. Ein Snapshot erklärt nicht, warum eine Seite rankt, ob sie jede Person zufriedenstellt oder welche Änderung sie verdrängen würde.
Halte Markt, Sprache, Gerät, Erhebungszeit und Tiefe an der Beobachtung. Eine Domain außerhalb der erfassten Tiefe ist nicht nachweislich in allen Ergebnissen abwesend. Wiederholte Messungen am selben Tag können den täglichen Datensatz aktualisieren, statt eine Intraday-Reihe anzulegen. Leite die Frequenz deshalb nicht aus der Zeilenzahl ab.
Der Wettbewerbskatalog beginnt mit Workspace-Evidenz und ausdrücklich gesetzten Domains
Domains aus gespeicherten SERPs können nach abgedeckten Keywords, Top-10-Vorkommen, abgedecktem Volumen, durchschnittlicher bester Position, bester Position und Lücken zusammengefasst werden. Eine Lücke liegt vor, wenn der Wettbewerber in den Top 10 erscheint und die konfigurierte eigene Domain nicht. Der Score ordnet den Katalog deterministisch. Er ist weder Marktanteil noch Beweis für dieselben Kunden.
Manuell gepflegte Wettbewerbsdomains können schon vor SERP- oder bezahlten Profildaten erscheinen. Bestätige eine echte Wettbewerbsbeziehung nach Prüfung und blende irrelevante Domains bei Bedarf aus. Nachrichtenseiten, Verzeichnisse, Marktplätze und Plattformen können häufig ranken, ohne kommerzielle Konkurrenten zu sein.
Trenne SERP-Überschneidung, Domain-Profil und Tiefenanalyse
Das Wettbewerbsdossier verbindet mehrere Schichten, macht sie aber nicht austauschbar. SERP-Überschneidung stammt aus gespeicherter Workspace-Evidenz. Domain-Profil ist eine bezahlte Aggregat-Anfrage mit organischen und bezahlten Keyword-Anzahlen, geschätztem Traffic-Volumen, einem Traffic-Kosten-Proxy, Bewegungszählern und Positionsbändern. Sie liefert keine Keyword-Zeilen.
Tiefenanalyse ist eine eigene bezahlte Ranking-Keyword-Anfrage mit einer gewählten Maximaltiefe von 100, 500, 1.000, 5.000 oder 10.000 Zeilen. Die Oberfläche zeigt angefragte Tiefe, gespeicherte Zeilenzahl und verfügbares Anbietergesamt. Ein gedeckeltes Ergebnis ist kein vollständiger Domain-Bestand. Traffic- und Kostenwerte sind Anbieterschätzungen, keine Analytics- oder Werbekontodaten.
| Dossier-Schicht | Inhalt |
|---|---|
| Aus deinen SERPs | Workspace-Überschneidung, beobachtete Ränge, URLs und Lückenkontext |
| Domain-Profil | Ein aggregierter Snapshot der organischen und bezahlten Präsenz |
| Tiefenanalyse | Angefragte Ranking-Keyword-Zeilen bis zur gewählten Tiefe |
| Alle Keywords | Zusammengeführte Prüfung der verfügbaren Dossier-Zeilen |
Bezahlte Wettbewerbsdaten bleiben bis zum Import ein Prüfartefakt
Domain-Profil und Tiefenanalyse durchlaufen Schätzung, Balance-Reservierung, externe Ausführung, Abrechnung der tatsächlichen Anbieterkosten und Freigabe des ungenutzten Rests. Frische Ergebnisse können nach aktueller Cache-Regel wiederverwendet werden, solange ein erzwungener Lauf nicht begründet ist. Running, done und failed gehören zur angefragten Operation.
Zeilen der Tiefenanalyse bleiben am Wettbewerbsdossier. Sie werden nicht automatisch zu Keyword-Datensätzen, einer Liste, einem Briefing oder einer redaktionellen Aufgabe. Importiere nur geprüfte Begriffe. Vorhandene normalisierte Datensätze bleiben dedupliziert, und der Import sollte verfügbare Herkunft und Metriken übertragen, ohne die Entscheidung über die Zielliste zu ersetzen.
Nutze eine direkte Auswahl oder eine Liste als Tracking-Kohorte
Ein SERP-Tracking-Zeitplan kann an eine feste direkte Auswahl normalisierter Keywords oder an eine benannte Liste gebunden sein. Die direkte Auswahl behält genau diese gespeicherten Begriffe. Ein listenbasierter Zeitplan löst die aktuelle Mitgliedschaft bei der Beanspruchung eines Laufs auf. Vorher hinzugefügte Begriffe kommen hinein, vorher entfernte nicht.
Nach der Beanspruchung bleibt die angefragte Zahl der Start-Scope dieses Laufs und folgt keinen Änderungen während der Ausführung. Nutze eine direkte Auswahl für eine kleine feste Kohorte und eine Liste, wenn bewusste Mitgliedschaftsänderungen spätere Läufe beeinflussen sollen. Der Zeitplan weist selbst weder Seite, Owner noch Redaktionsstatus zu.
Position ist eine datierte Beobachtung für Domain und SERP-Kontext
Position ist der neueste gespeicherte organische Rang der konfigurierten eigenen Domain für Keyword, Standort, Sprache, Gerät, Tiefe und Erhebungszeit. Ein leerer Wert kann fehlende Messung, keinen Treffer in der erfassten Tiefe, nicht verfügbare Daten oder eine fehlende eigene Domain bedeuten. Er ist nicht Position null.
Vergleiche nur kompatible Kontexte. Eine Desktop-Beobachtung aus einem Land ist nicht der Mobile-Rang in einem anderen. Der Wert dokumentiert den beobachteten Ort der Domain. Er erklärt weder die Bewegung noch Traffic oder die Übereinstimmung der Ranking-URL mit der vom Team gewünschten Seite.
Position Change vergleicht zwei verwendbare Beobachtungen
Das Feld vergleicht die aktuelle Position mit der vorherigen verwendbaren Beobachtung im selben unterstützten Kontext. Weil eine kleinere Rangzahl besser ist, lies Richtung, früheren Wert und beide Daten. Fehlt die frühere Beobachtung, bleibt die Veränderung unbekannt und wird nicht zu null.
Bewegung kann aus gewöhnlicher SERP-Volatilität, einer anderen Ranking-URL, einem verlorenen Ergebnis, einer Messlücke oder echter Leistung entstehen. Prüfe Beobachtungen, SERP Dynamics, Ranking-URL, Ergebnisfeatures und relevante Website-Ereignisse, bevor du Ursache oder Aufgabe festlegst.
Position Trend zeigt die Form der gespeicherten Reihe
Der Trend hilft, einen einzelnen Sprung von wiederholten Gewinnen, Verlusten, Richtungswechseln oder Lücken zu unterscheiden. Er entsteht aus den erhobenen Snapshots für Keyword und konfigurierten Domain-Kontext. Fehlende Tage werden nicht still als unveränderte Position ergänzt.
Nutze die Linie, um Kandidaten für eine genauere Timeline-Prüfung zu finden. Sie beweist keine Wirkung eines Releases, Content-Updates, technischen Fixes oder einer Linkkampagne. Gleiche Snapshots mit datierten Website-Ereignissen ab und prüfe, ob die beobachtete Ranking-URL gleich blieb.
Position History trennt aktuelle, geplante und rückwirkende Beobachtungen
Einmalige aktuelle SERP-Anfragen, geplantes Tracking und historische Backfills können datierte Rank-Snapshots mit eigener Quelle beitragen. Historische Delta-Felder vergleichen die jüngste Beobachtung mit einem verwendbaren Punkt nahe 3, 6, 9 oder 12 Monaten. Ohne vergleichbare Grundlage bleibt das Feld leer.
Top-10-Domains können in der Reihe erscheinen, solange sie in den beobachteten Top 10 liegen. Ausdrücklich getrackte Domains können dagegen Lücken behalten, wenn kein Rang gefunden wurde. Historische Charts können außerdem Klicks oder Traffic-Wert mit Volumen und fester Klickkurve schätzen. Das sind Modelle, keine Analytics-Sitzungen oder Umsätze.
Ein Tracking-Zeitplan braucht einen reproduzierbaren Messvertrag
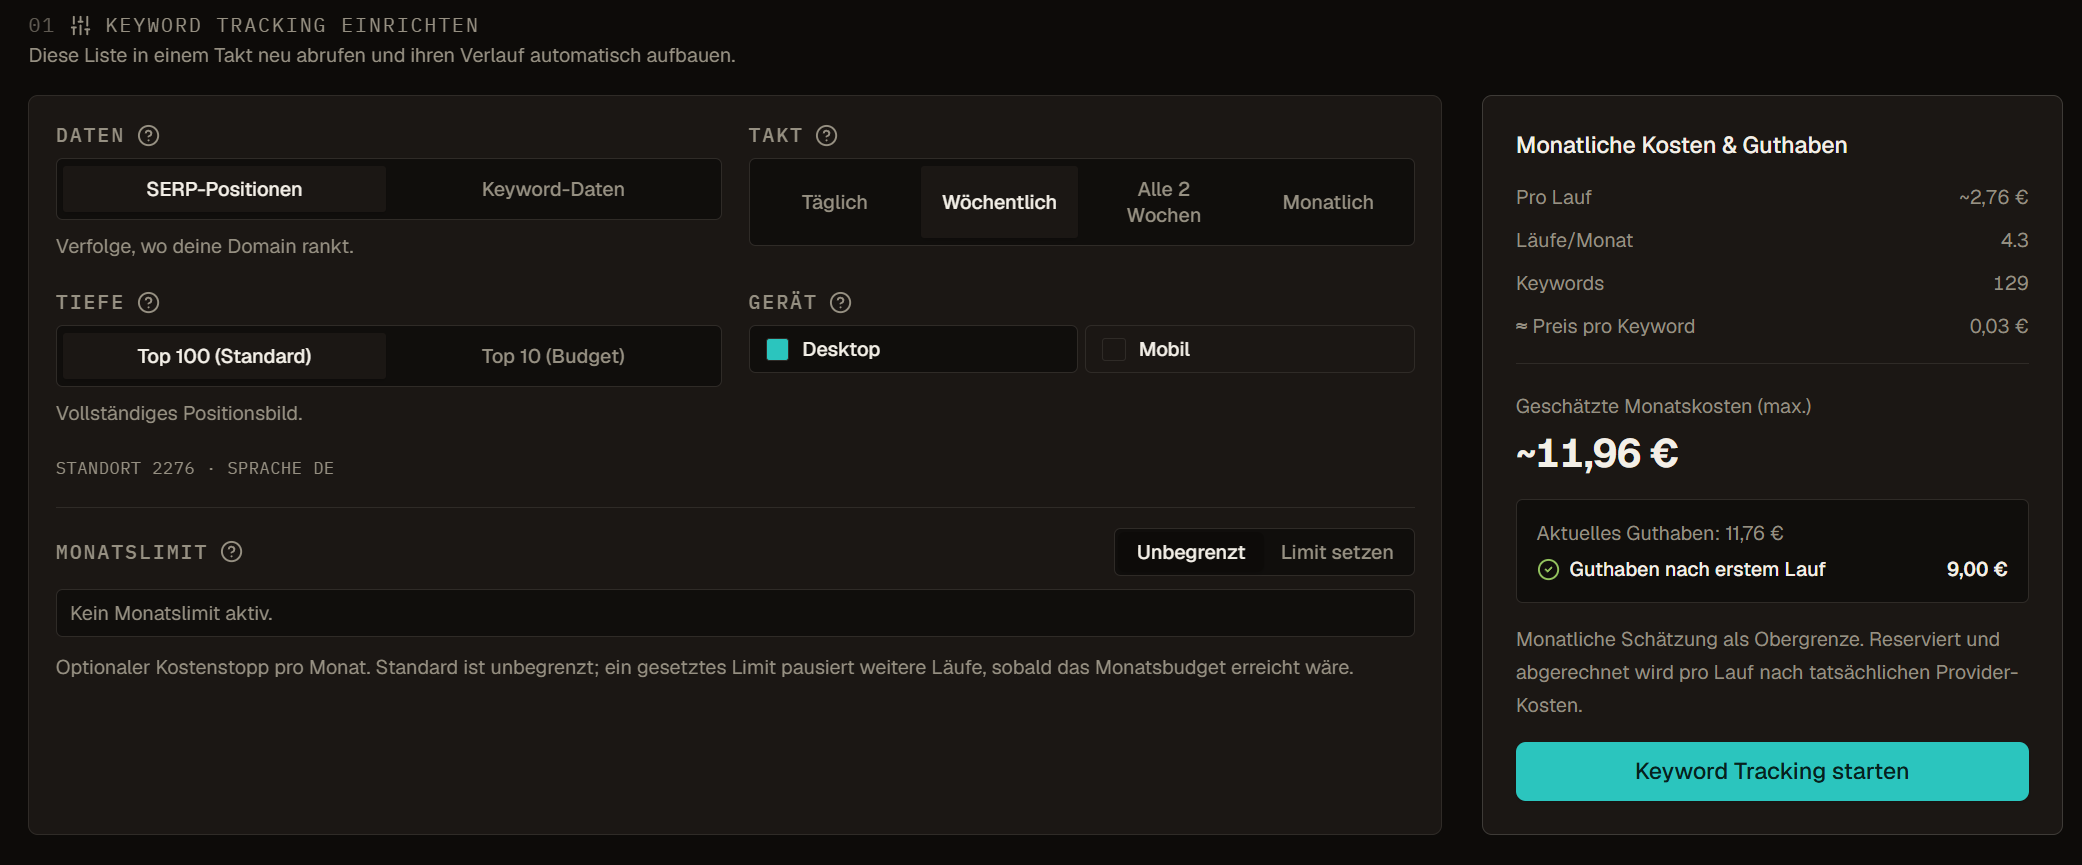
Für SERP-Tracking wählst du Keyword-Kohorte, Standort, Sprache, eines oder beide unterstützten Geräte, Top-10- oder Top-100-Tiefe und Takt. SERP-Zeitpläne können täglich, wöchentlich, zweiwöchentlich oder monatlich laufen. Ein separater Keyword-Daten-Zeitplan kann ausgewählte Datenpakete monatlich oder quartalsweise aktualisieren, weil diese Felder keinen täglichen Positionstakt brauchen.
Das Formular schätzt Kosten pro Lauf und durchschnittliche Monatskosten aus Kohorte, Geräten, Tiefe, Paketen und Takt. Es zeigt die Balance und erlaubt eine optionale monatliche Budgetgrenze. Unbegrenzt bedeutet nicht unbegrenzte Balance, und eine Schätzung ist keine Endabrechnung. Prüfe die Konfiguration nach Änderungen an Listengröße oder Geräten erneut.
- Bestätige eigene Domain und Markt vor der ersten Baseline.
- Wähle Top 10, wenn Präsenz auf Seite eins genügt, und Top 100, wenn tiefere Abwesenheit relevant ist.
- Tracke Desktop und Mobile innerhalb des Zeitplans getrennt, wenn beide Kontexte zählen.
- Benenne listenbasierte Kohorten nach Zweck, Markt und Review-Verantwortung.
- Setze die Budgetgrenze nach erwartetem Review-Nutzen, nicht nach dem Maximum des Reglers.
- Lege doppelte Kontexte bewusst an. Passende aktive Zeitpläne werden als Duplikat abgelehnt.
Prüfe vor wiederkehrenden Messungen die Tracking-Zeitpläne und Kosten für die vorgesehene Keyword-Gruppe.
Erstellung, manueller Lauf, Takt und Lebenszyklus sind getrennte Kontrollen
Beim Erstellen wird ein zukünftiger nächster Lauf gespeichert, während die Oberfläche die erste Baseline über den manuellen Laufpfad startet. Spätere Läufe werden im gewählten Takt beansprucht. Jetzt ausführen nutzt die normal bepreiste Queue. Für SERP-Zeitpläne kann zusätzlich eine separat geschätzte schnellere Queue für diesen einen Lauf erscheinen. Bei inaktivem oder laufendem Zeitplan, Budgetgrenze oder fehlender Balance kann der Klick ohne neuen Lauf enden.
Pausieren stoppt zukünftige Beanspruchungen, ohne den Zeitplan zu zerstören. Fortsetzen aktiviert ihn wieder. Beenden archiviert ihn und entfernt ihn aus dem normalen Dispatch. Änderungen an Kohorte, Takt, Geräten, Tiefe, Paketen oder Budget gelten für künftige Läufe, nicht für den unveränderlichen Start-Scope eines bereits beanspruchten Laufs.
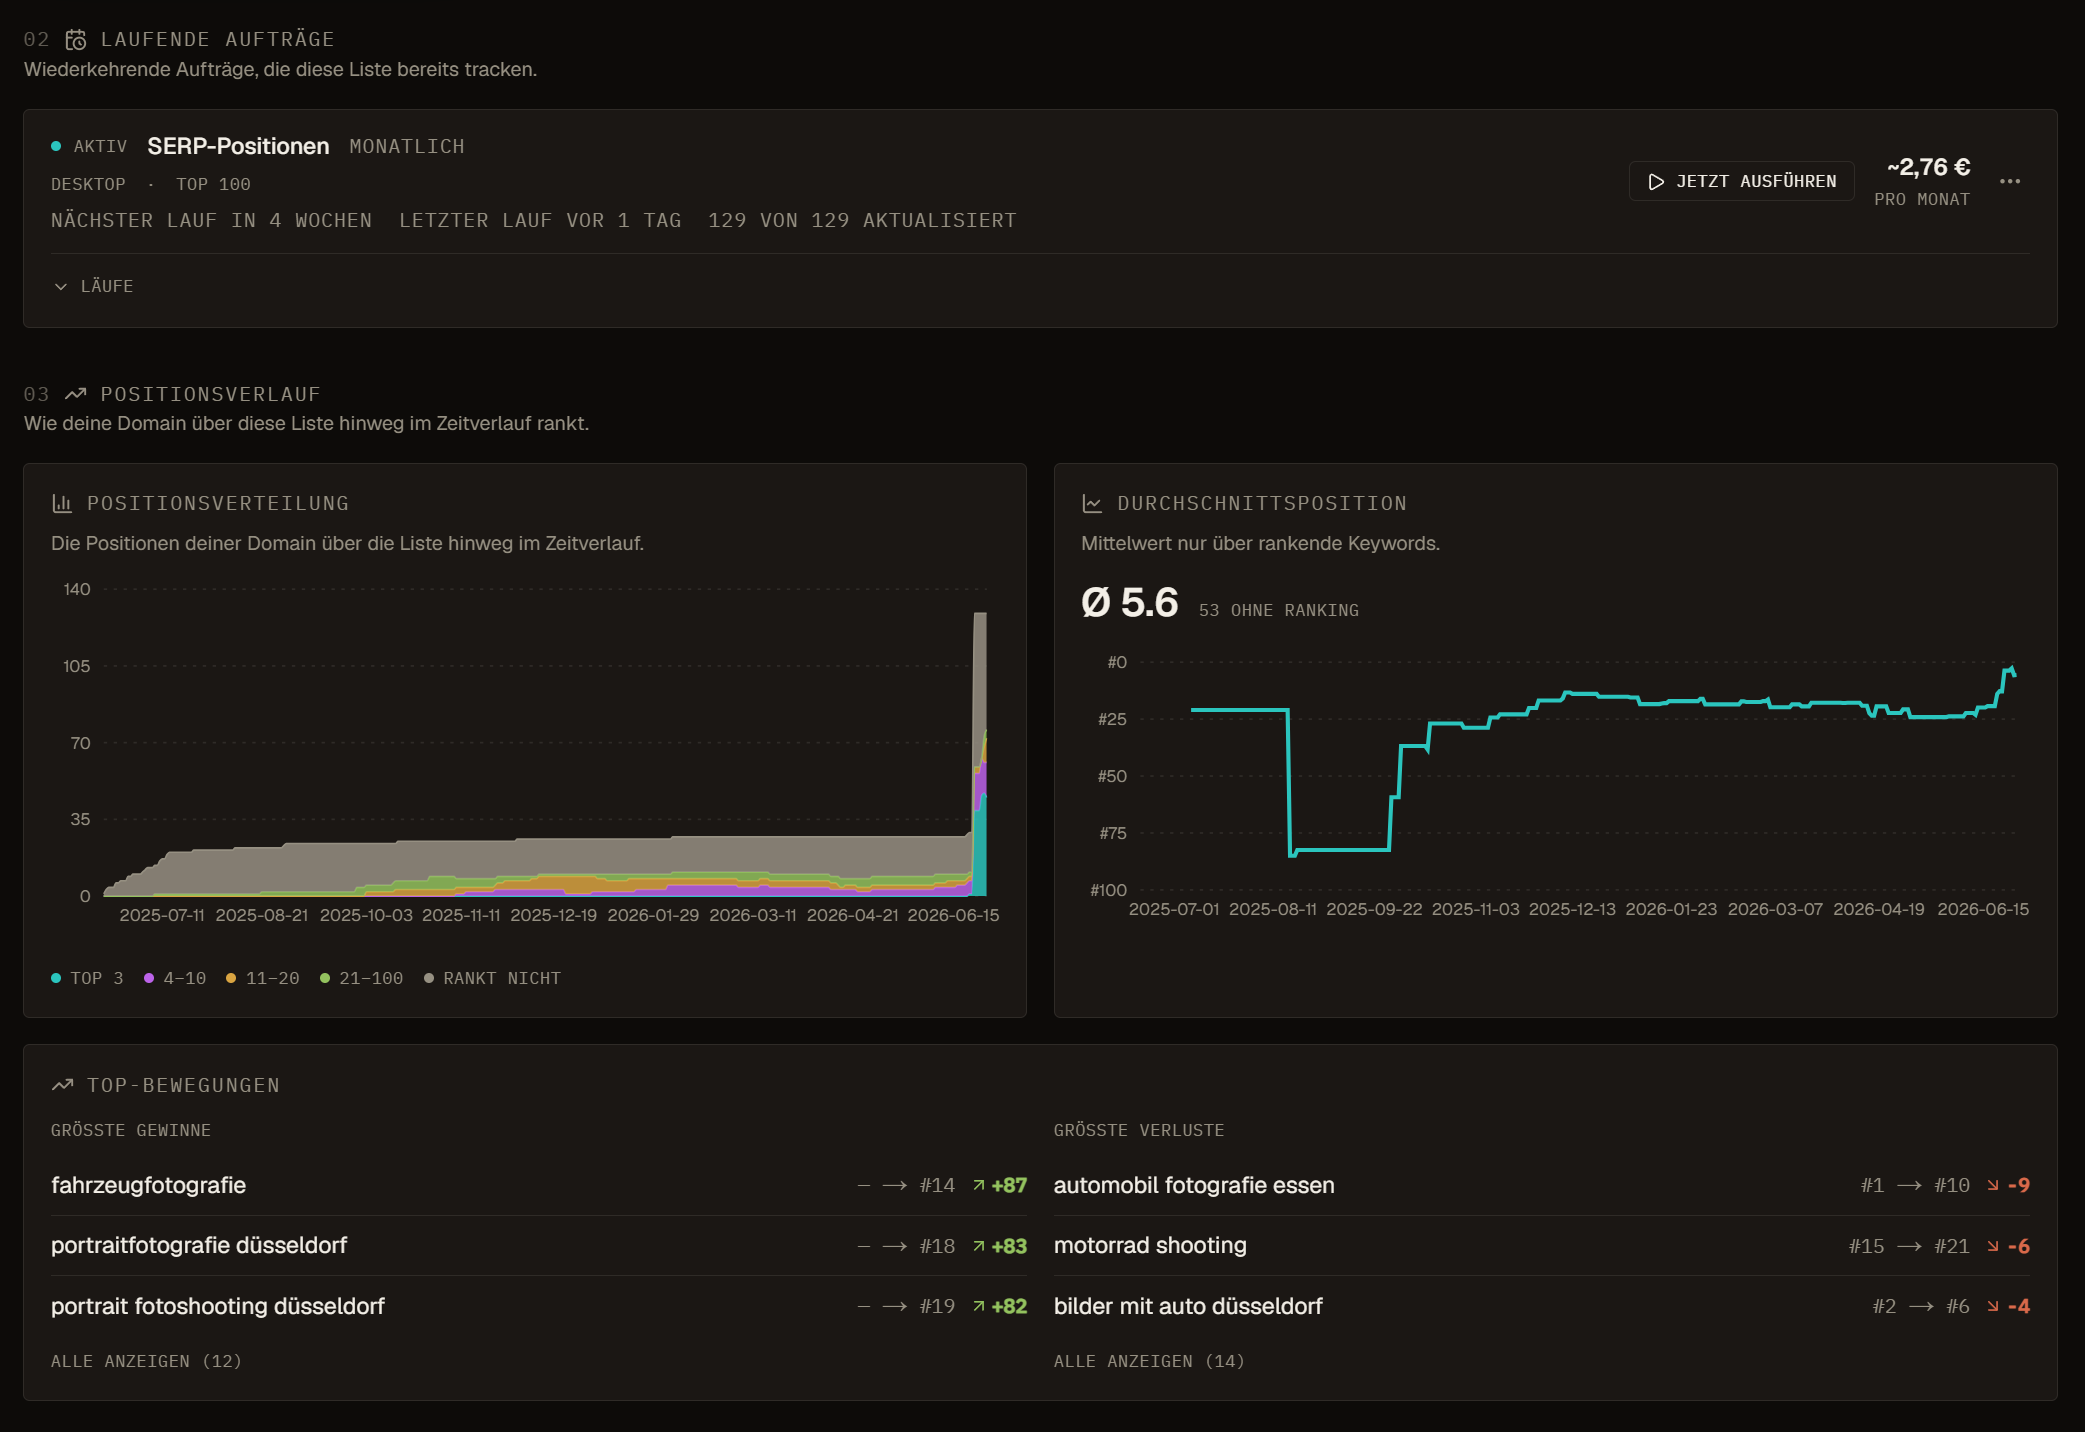
Lies das Tracking-Dashboard innerhalb seines Aggregationsmodus
Das Listen-Dashboard kann aktuelle Verteilung, Durchschnittsposition, Bewegung und verfügbare Historie zusammenfassen. Bis zur unterstützten historischen Schwelle kann es gespeicherte Snapshots pro Keyword aggregieren. Größere Listen verwenden eine aktuelle Projektion aus denormalisierten Positionsfeldern, damit der Leseweg begrenzt bleibt und nicht jede Historienzeile scannt.
Die Oberfläche kennzeichnet diesen Current-Projection-Modus. Präsentiere ihn nicht als vollständigen historischen Rollup. Vergleiche denselben Scope und Kontext, lege fehlende Abdeckung offen und öffne die Keyword-Timeline, wenn eine Aggregatbewegung erklärt werden muss.
Balance und Laufergebnis gehören zur Messung
Jeder beanspruchte bezahlte Lauf reserviert vor der Ausführung die geschätzte Balance. Abgeschlossene Keyword-Ergebnisse werden mit den tatsächlichen Anbieterkosten abgerechnet, ungenutzte Reservierung wird freigegeben. Ein Zeitplan mit mehreren Geräten kann getrennte Kindläufe in einer logischen Gruppe erzeugen. No data, partial, failed, skipped balance und skipped dispatch bleiben verschiedene Zustände.
Das Laufprotokoll hält angefragte und erhaltene Mengen, Endstatus, Zeit und abgerechnete Kosten fest. Null Kosten können bedeuten, dass keine abrechenbaren Daten geliefert wurden, nicht dass der Zeitplan kostenlos ist. Wiederholte Fehler oder Balance-Probleme können den Betrieb pausieren. Prüfe das Protokoll, statt den nächsten Termin als Erfolgsgarantie zu lesen.
Activity und Laufprotokoll beweisen die Ausführung, nicht der Button
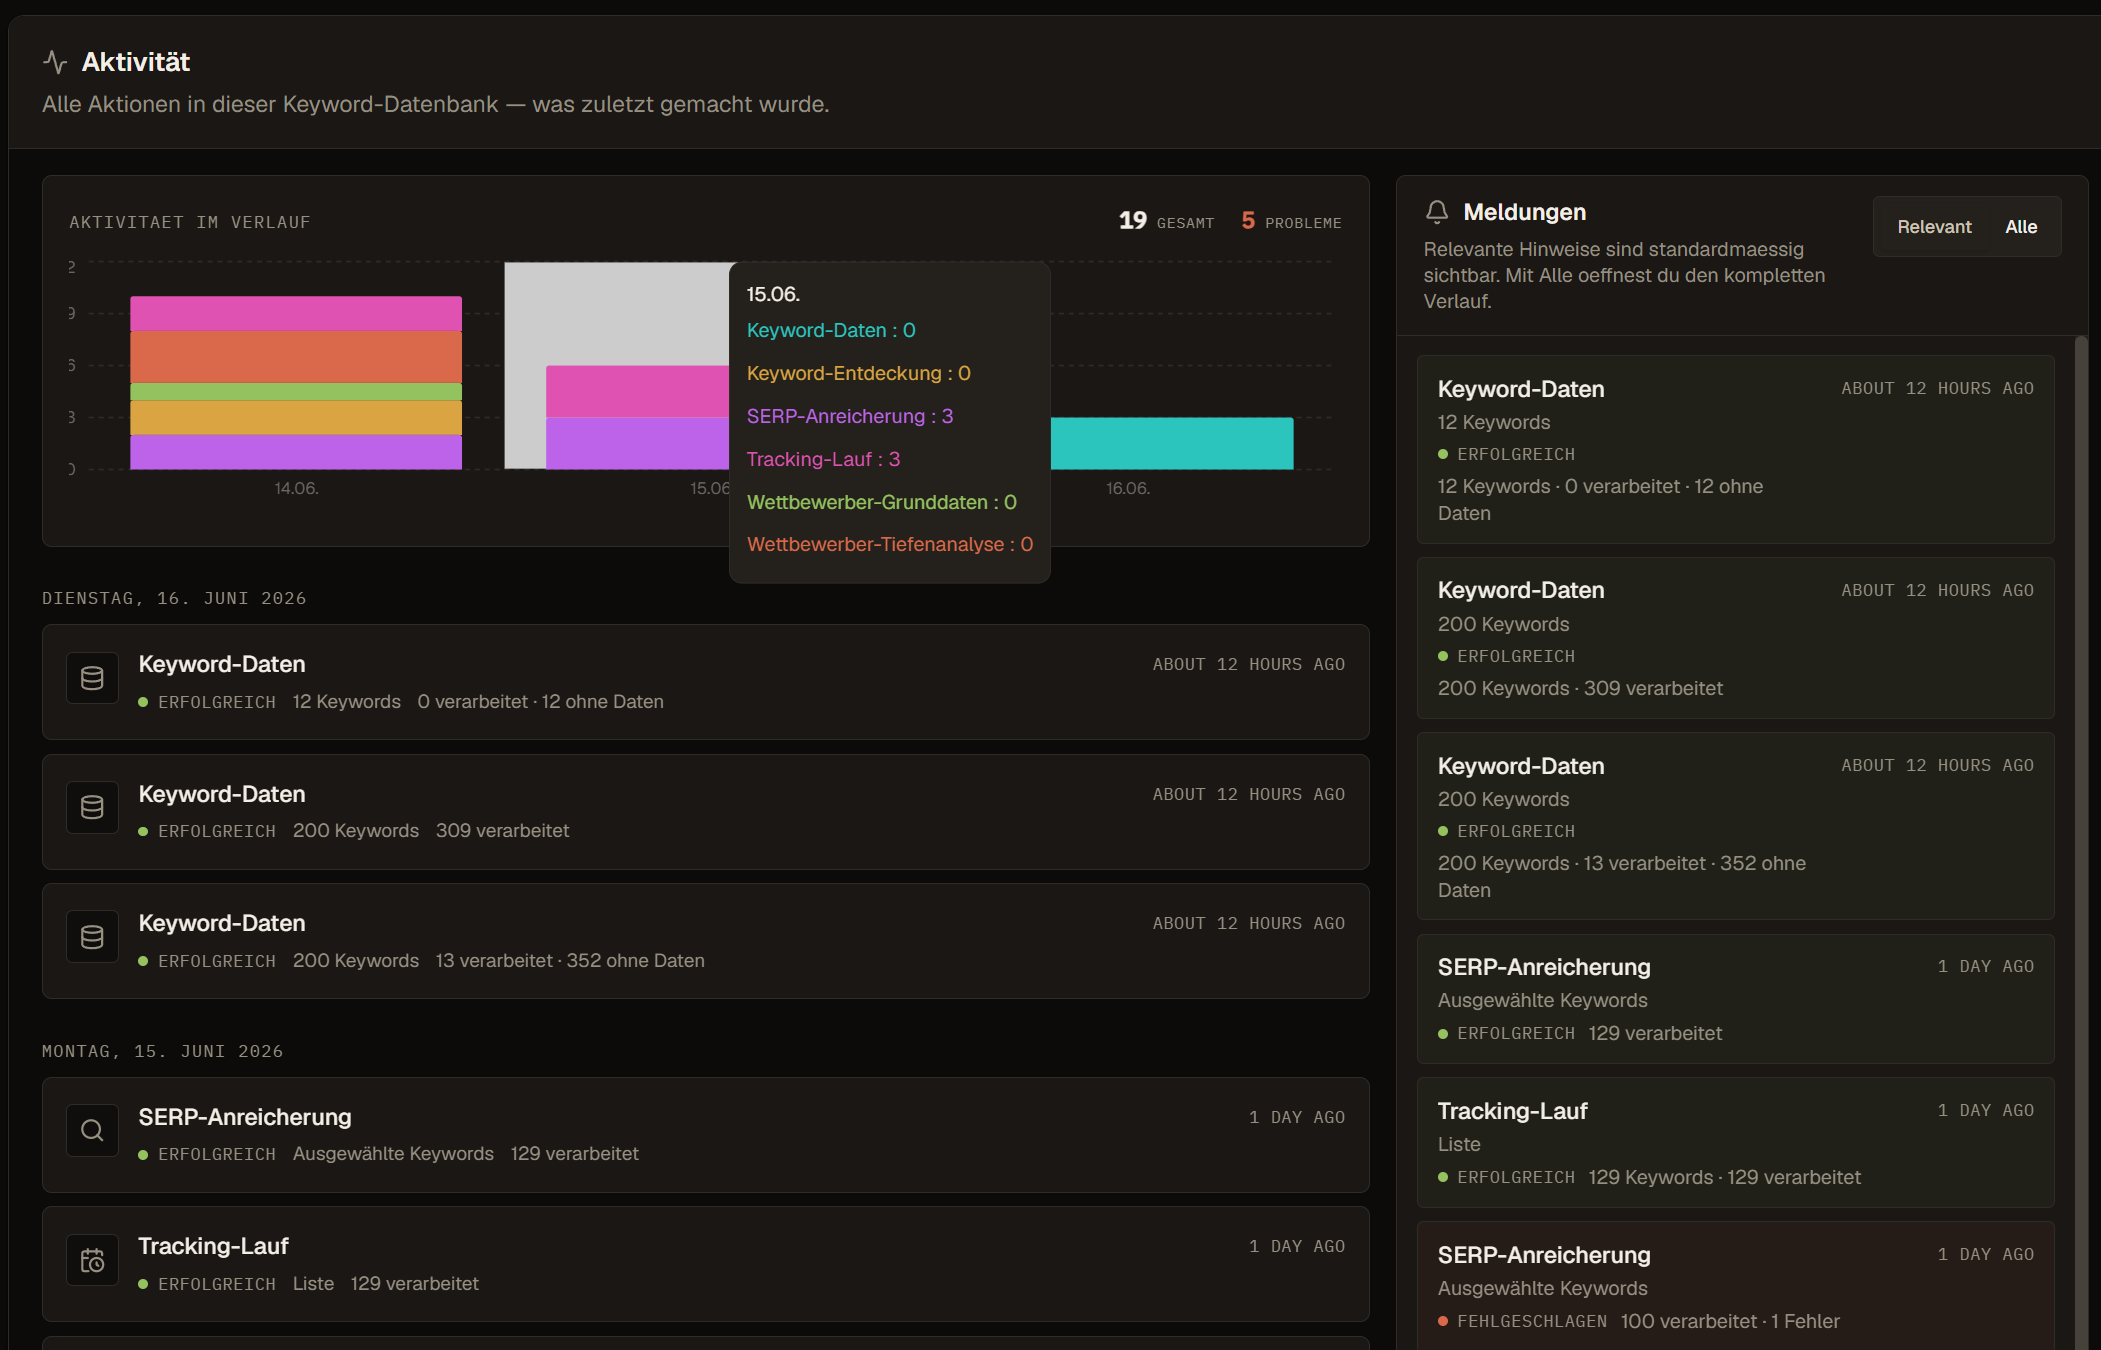
Nutze Activity für SERP-Anreicherungen und Wettbewerbsoperationen, das Tracking-Laufprotokoll für Zeitplanergebnisse. Prüfe Aktion, Start-Scope, Start und Ende, angefragte Zeilen, erfolgreiche Zeilen, No-Data-Zeilen, Fehler, Kosten und sichtbaren Fehlercode. Queued oder running ist nicht abgeschlossen, partial nicht dasselbe wie vollständiges Scheitern.
Bleibt ein Wert unverändert, bestätige zuerst, dass der richtige Job beendet wurde und die Zeile in seinem beanspruchten Scope lag. Vergleiche dann Quelle und Datendatum. Eine Wiederholung ohne diese Prüfung kann doppelt kosten, brauchbaren aktuellen Kontext überschreiben oder den ursprünglichen Fehler hinter einem späteren Lauf verbergen.
Von der Momentaufnahme zum kontrollierten Tracking
Beispiel: Von der Shortlist zum wöchentlichen Tracking
Ein Team fordert SERP-Snapshots für eine geprüfte Shortlist an, um zu sehen, welche Seitentypen ranken und ob die eigene Domain erscheint. Eine Wettbewerber-Domain taucht bei vielen Begriffen auf.
Das Team öffnet diese Domain im Wettbewerber-Dossier und legt danach einen wöchentlichen Tracking-Zeitplan für die Shortlist auf Desktop und Mobil an. Das Formular zeigt Kosten pro Lauf und durchschnittliche Monatskosten, bevor der Zeitplan gespeichert wird.
Häufige Fragen
Werden SERP-Features für jedes Keyword automatisch abgerufen?
Nein. SERP-Daten werden gezielt für ausgewählte Keywords angefordert. Features wie AI Overview, Featured Snippet oder People Also Ask werden für diesen Snapshot und seinen Markt, seine Sprache und sein Gerät festgehalten.
Welche Liefermodi gibt es für SERP-Anfragen?
Live, Priority und Standard liefern aktuelle Ergebnisse und wägen Lieferzeit gegen Kosten ab. Der historische Modus fragt monatliche Beobachtungen für 3, 6, 9 oder 12 Monate ab und schreibt einen Positionsverlauf.
Wie oft lassen sich Rankings tracken?
SERP-Tracking läuft täglich, wöchentlich, alle zwei Wochen oder monatlich, für Desktop, Mobil oder beides, mit Top-10- oder Top-100-Tiefe. Keyword-Daten lassen sich monatlich oder vierteljährlich aktualisieren.
Was passiert, wenn ich einer getrackten Liste Keywords hinzufüge?
Ein listenbasierter Zeitplan nutzt die Mitglieder, die beim Start eines Laufs in der Liste stehen. Neue Begriffe sind also beim nächsten Lauf dabei, ein bereits laufender Lauf behält seinen Umfang.