Relier preuves SERP, revue concurrentielle et suivi de position
Gardez les définitions des indicateurs de mots-clés à portée de main pour déterminer ce qu'un instantané des résultats peut expliquer.
Une observation SERP datée
Des preuves concurrentielles en couches
Une série de mesure contrôlée
Choisir la couche de preuve avant de demander des données
Les preuves SERP, les données concurrentielles et le suivi de position répondent à des questions différentes. Un snapshot demandé consigne ce qui apparaît pour un mot-clé dans un contexte de recherche défini. Les surfaces concurrentielles agrègent les domaines et ajoutent, sur demande, un profil ou des mots-clés classés. Le suivi répète une mesure contrôlée et conserve un registre de chaque exécution.
Ces couches peuvent se nourrir sans devenir le même jeu de données. Un snapshot peut révéler un domaine, le catalogue peut le conserver pour examen et un suivi peut ensuite mesurer votre domaine sur un ensemble approuvé. Chaque couche garde son périmètre, sa date, son chemin de coût et ses états manquants.
| Question | Surface adaptée |
|---|---|
| Que montre la page de résultats maintenant? | Demande SERP ponctuelle |
| Quels domaines reviennent dans les preuves du workspace? | Catalogue concurrentiel et chevauchement SERP |
| Quelle présence organique ou payante plus large possède un domaine? | Profil de domaine ou analyse approfondie demandée |
| Comment notre position évolue-t-elle dans un contexte fixe? | Programme de suivi de position |
| La demande a-t-elle fini, échoué ou consommé du solde? | Activité et journal des exécutions |
Demander une SERP lorsque l'environnement peut changer la décision
Une demande ponctuelle convient lorsque vous avez besoin des premiers résultats observés, des modules pris en charge, de la position du domaine configuré, des URL classées ou d'une base datée pour le chevauchement concurrentiel. Elle apporte davantage à une sélection déjà examinée qu'à un inventaire dont la pertinence reste inconnue.
La demande est un travail externe payant. Confirmez les mots-clés normalisés, le lieu, la langue, le mode, les lignes auxquelles il manque des données, les résultats en cache, l'estimation et le solde. L'interface traite de grandes sélections par lots bornés, mais une demande acceptée ne prouve pas que chaque terme a renvoyé des données.
- Commencer par les lignes dont les types de résultats ou les pages classées influencent la page cible.
- Utiliser Seulement les données manquantes lorsque la sélection mélange des lignes complètes et incomplètes.
- Les lignes encore fraîches dans le cache sont ignorées sauf remplacement express.
- Forcer une actualisation peut consommer du solde sans changer la décision.
- Après le traitement, vérifier les nombres demandés, terminés, sans données, en échec et réutilisés.
Choisir le mode de livraison selon l'échéance et le besoin
Live, Priority et Standard peuvent fournir les champs SERP actuels, avec un compromis entre délai et coût estimé. Historical demande des observations mensuelles sur 3, 6, 9 ou 12 mois et écrit un historique de positions. Il ne présente pas une ancienne page de résultats comme actuelle.
Lisez l'estimation affichée car prix, lignes, cache et durée historique modifient la réservation. Live n'est pas plus précis parce qu'il est plus rapide. Standard n'est pas ancien parce qu'il passe par une file asynchrone. Une observation historique garde sa propre date lorsqu'elle est comparée à un snapshot actuel.
| Mode | À utiliser lorsque |
|---|---|
| Live | Le résultat actuel est nécessaire dans la revue en cours |
| Priority | Une file plus rapide justifie le supplément affiché |
| Standard | Le coût compte davantage que la livraison immédiate |
| Historical | Une série datée vaut mieux qu'un nouveau snapshot actuel |
SERP Features décrit les modules détectés dans un snapshot demandé
Le champ peut enregistrer AI Overview, Featured Snippet, People Also Ask, Local Pack, images, vidéos, Shopping, Knowledge Panel, Site Links, Top Stories, modules sociaux, Jobs et FAQ. Ces indicateurs sont des données SERP demandées à dessein. Ils ne sont pas collectés automatiquement pour tous les mots-clés.
Un indicateur signifie que le module a été détecté à cette date dans ce marché, cette langue, cet appareil et ce contexte. Il ne prouve ni que votre domaine le possède, ni son effet sur les clics. Vérifiez le snapshot et sa date avant de modifier une page ou de prévoir le potentiel de clic.
Pour comparer des domaines entiers plutôt qu'une seule page de résultats, passez à l'analyse concurrentielle avec une question précise.
Lire les premiers résultats avant d'attribuer une cause
Les résultats observés peuvent fournir domaines, URL, positions et contexte de liens ou de modules. Comparez les types de pages, les tâches de recherche, les domaines récurrents et la présence de votre domaine. Un snapshot n'explique pas pourquoi une page se classe, si elle satisfait chaque personne ni quel changement la dépasserait.
Conservez marché, langue, appareil, date et profondeur avec l'observation. Un domaine absent de la profondeur acquise n'est pas forcément absent de tous les résultats. Des mesures répétées le même jour peuvent mettre à jour la ligne quotidienne au lieu de produire une série intrajournalière. Ne déduisez pas la fréquence du nombre de lignes.
Le catalogue concurrentiel part des preuves du workspace et des domaines explicites
Les domaines observés peuvent être résumés par mots-clés couverts, présences dans le top 10, volume couvert, meilleure position moyenne, meilleure position et lacunes. Une lacune signifie que le concurrent apparaît dans le top 10 alors que le domaine propre configuré n'y apparaît pas. Le score ordonne le catalogue. Ce n'est ni une part de marché ni la preuve d'une clientèle commune.
Un domaine ajouté manuellement peut apparaître avant toute SERP ou donnée payante. Confirmez un concurrent réel après examen et masquez un domaine non pertinent si nécessaire. Sites d'actualité, annuaires, places de marché et plateformes peuvent se classer souvent sans être des concurrents commerciaux.
Séparer chevauchement SERP, profil de domaine et analyse approfondie
Le dossier rassemble plusieurs couches sans les rendre interchangeables. Le chevauchement vient des résultats stockés dans le workspace. Profil de domaine est une demande payante agrégée avec nombres de mots-clés organiques et payants, trafic estimé, proxy de coût du trafic, compteurs de mouvement et bandes de position. Il ne fournit aucune ligne de mot-clé.
Analyse approfondie est une demande payante distincte de mots-clés classés, limitée au choix à 100, 500, 1 000, 5 000 ou 10 000 lignes. L'interface affiche profondeur demandée, lignes stockées et total du fournisseur lorsqu'il existe. Un résultat plafonné n'est pas l'inventaire complet du domaine. Trafic et coût restent des estimations externes.
| Couche du dossier | Ce qu'elle contient |
|---|---|
| Depuis vos SERP | Chevauchement du workspace, rangs, URL et contexte de lacune |
| Profil de domaine | Un snapshot agrégé de la présence organique et payante |
| Analyse approfondie | Des lignes classées jusqu'à la profondeur choisie |
| Tous les mots-clés | Une revue fusionnée des lignes disponibles |
Les données concurrentielles payantes restent un artefact de revue jusqu'à l'import
Profil de domaine et Analyse approfondie suivent estimation, réservation du solde, exécution externe, règlement du coût réel et libération du reliquat. Des résultats frais peuvent être réutilisés selon la politique de cache tant qu'une nouvelle collecte forcée n'est pas justifiée. Running, done et failed appartiennent à l'opération demandée.
Les lignes approfondies restent dans le dossier. Elles ne deviennent automatiquement ni enregistrements de la Base, ni liste, ni brief, ni tâche éditoriale. Importez seulement les termes examinés. Les enregistrements normalisés existants restent dédupliqués et l'import conserve le contexte disponible sans décider à votre place de la liste destinataire.
Utiliser une sélection directe ou une liste comme cohorte de suivi
Un programme SERP peut porter sur une sélection fixe de mots-clés normalisés ou sur une liste nommée. La sélection reste liée à ces termes. Pour une liste, l'appartenance est résolue au moment où l'exécution est réclamée. Les termes ajoutés avant y participent et ceux retirés avant en sont exclus.
Une fois réclamée, l'exécution conserve son nombre de départ et ne suit pas les modifications faites pendant le travail. Choisissez une sélection pour une petite cohorte fixe et une liste lorsque les changements d'appartenance doivent influencer les prochaines exécutions. Le programme n'attribue ni page, ni responsable, ni statut éditorial.
Position est une observation datée pour un domaine et un contexte SERP
Position est le dernier rang organique stocké pour le domaine propre, le mot-clé, le lieu, la langue, l'appareil, la profondeur et la date disponibles. Une cellule vide peut signifier absence de mesure, aucun résultat dans la profondeur acquise, données indisponibles ou domaine propre manquant. Ce n'est pas la position zéro.
Comparez seulement des contextes compatibles. Une mesure desktop dans un pays n'est pas le rang mobile dans un autre. Le champ consigne où le domaine a été observé. Il n'explique ni le mouvement, ni le trafic, ni si l'URL classée est celle voulue par l'équipe.
Position Change compare deux observations exploitables
Le champ compare la position actuelle à l'observation exploitable précédente dans le même contexte. Comme un rang plus petit est meilleur, lisez direction, ancienne valeur et deux dates. Sans observation antérieure, la variation reste inconnue et ne devient pas zéro.
Le mouvement peut venir de la volatilité normale, d'une autre URL, d'un résultat perdu, d'un trou de mesure ou d'une évolution réelle. Vérifiez observations, SERP Dynamics, URL classée, modules et événements du site avant d'attribuer une cause ou une tâche.
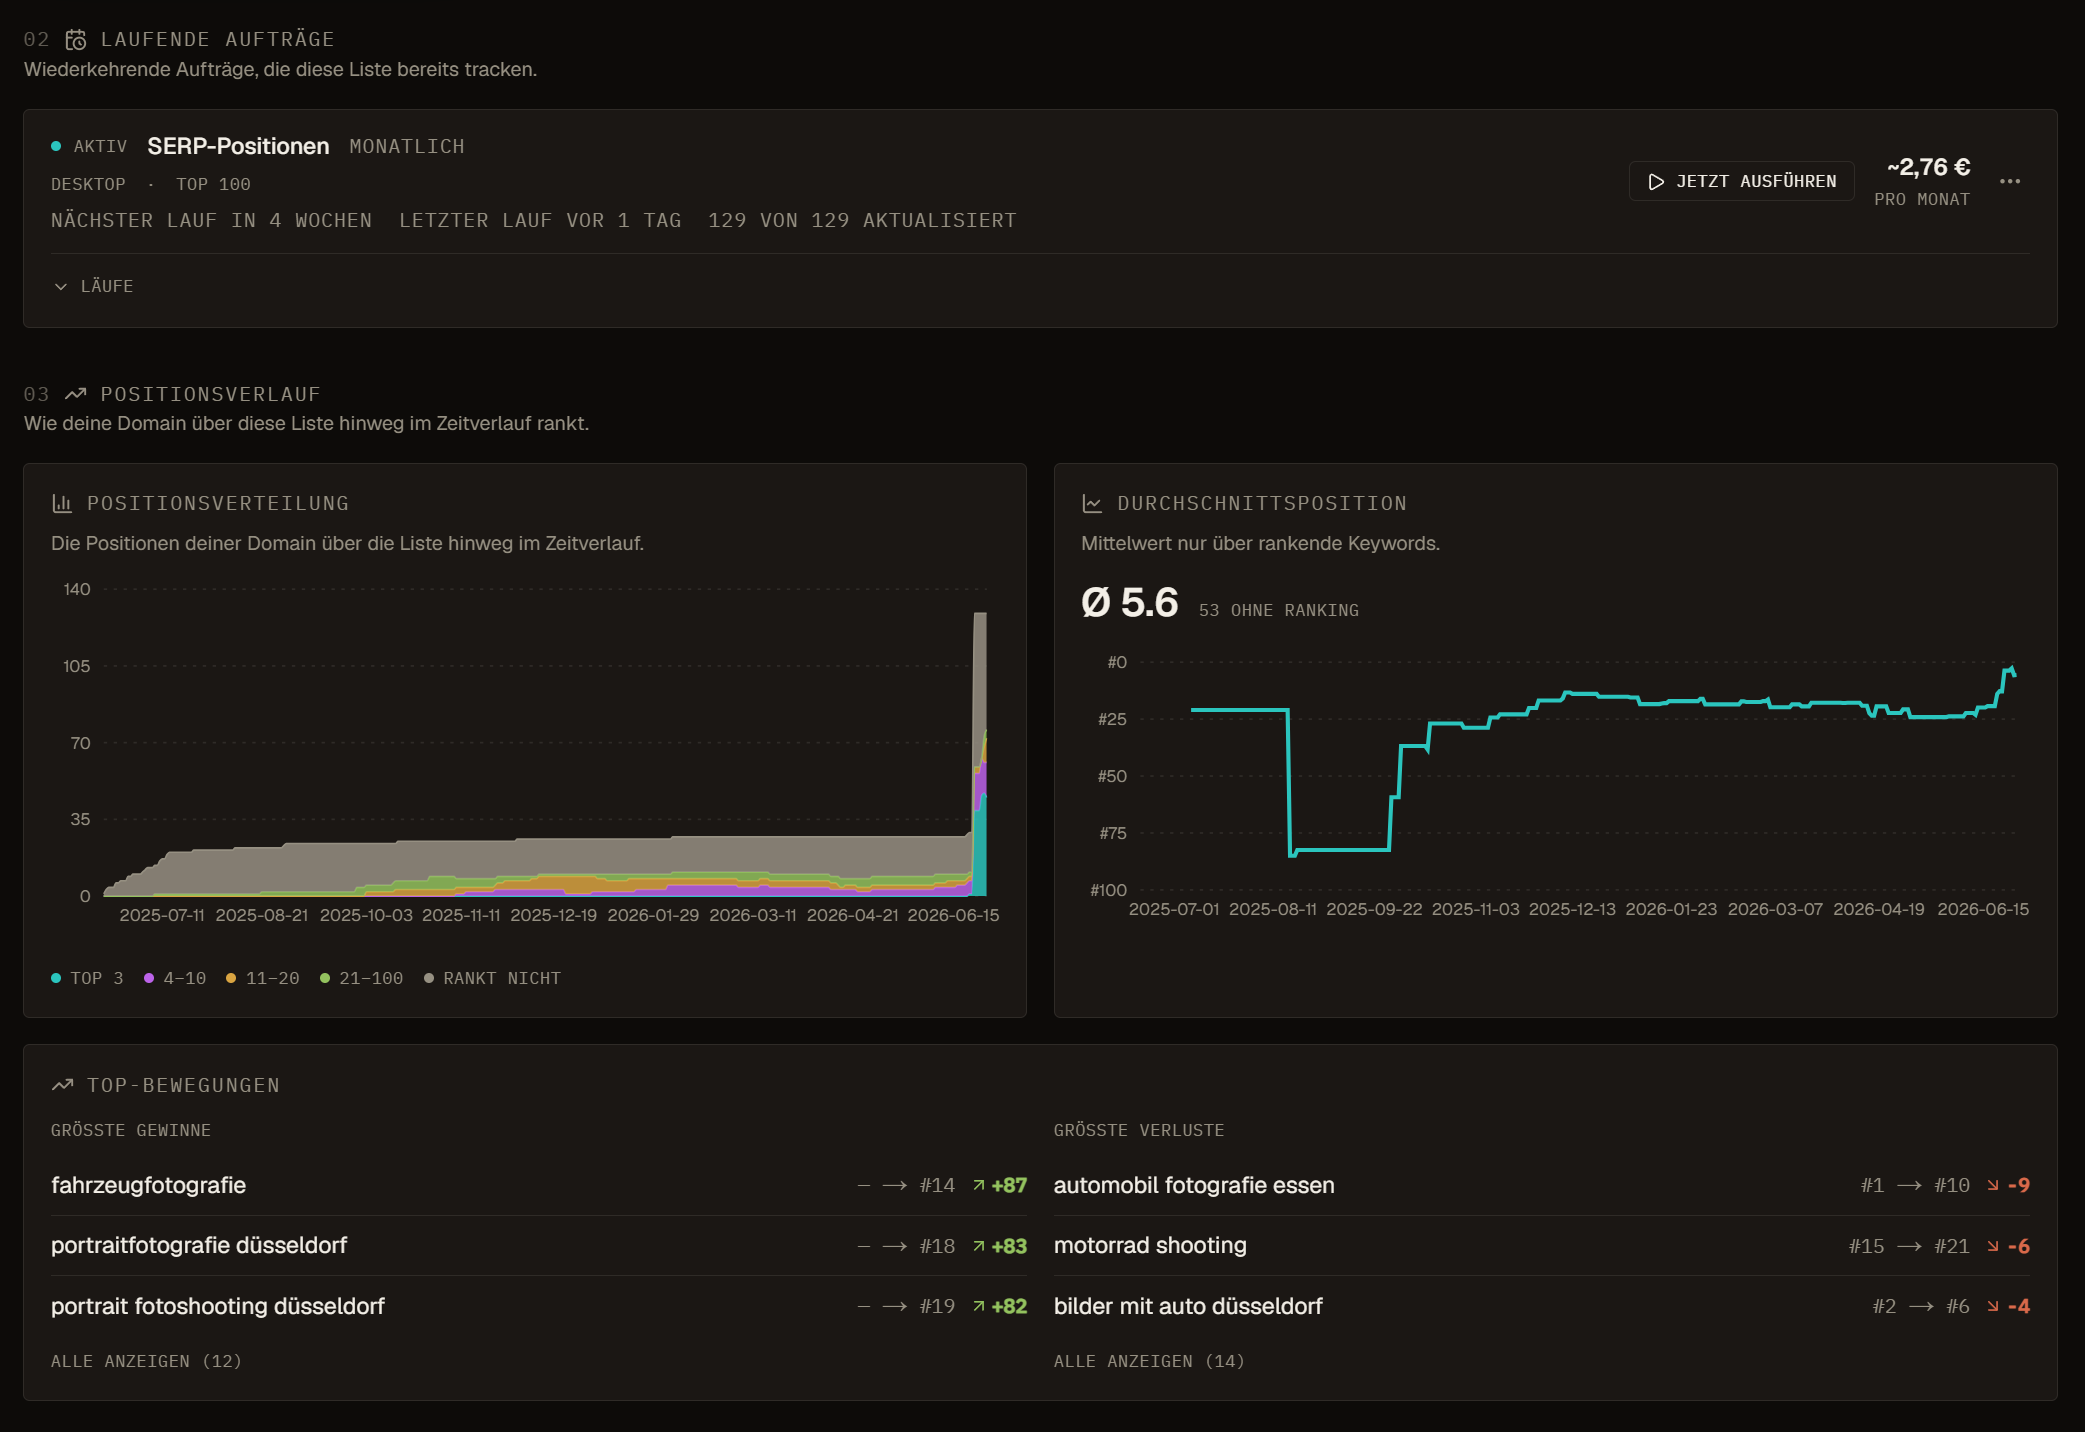
Position Trend montre la forme de la série stockée
La tendance distingue un saut isolé d'une suite de gains, pertes, retournements ou lacunes. Elle repose sur les snapshots acquis pour le mot-clé et le domaine configuré. Les jours absents ne sont pas remplis comme positions inchangées.
Utilisez la ligne pour sélectionner les cas qui méritent une chronologie. Elle ne prouve pas l'effet d'une publication, d'une mise à jour, d'une correction technique ou d'une campagne de liens. Alignez les points avec les événements datés et vérifiez si l'URL classée est restée la même.
Position History distingue observations actuelles, planifiées et rétrospectives
Demandes ponctuelles, suivi planifié et rattrapages historiques peuvent tous écrire des snapshots datés avec leur source. Les écarts historiques comparent la dernière observation à un point exploitable proche de 3, 6, 9 ou 12 mois. Sans base comparable, ils restent vides.
Les domaines du top 10 peuvent apparaître tant qu'ils restent dans le top 10 observé, alors que les domaines explicitement suivis conservent des lacunes quand aucun rang n'est trouvé. Les graphiques peuvent estimer clics ou valeur avec volume et courbe fixe. Ce ne sont ni sessions Analytics ni revenus.
Un programme de suivi exige un contrat de mesure reproductible
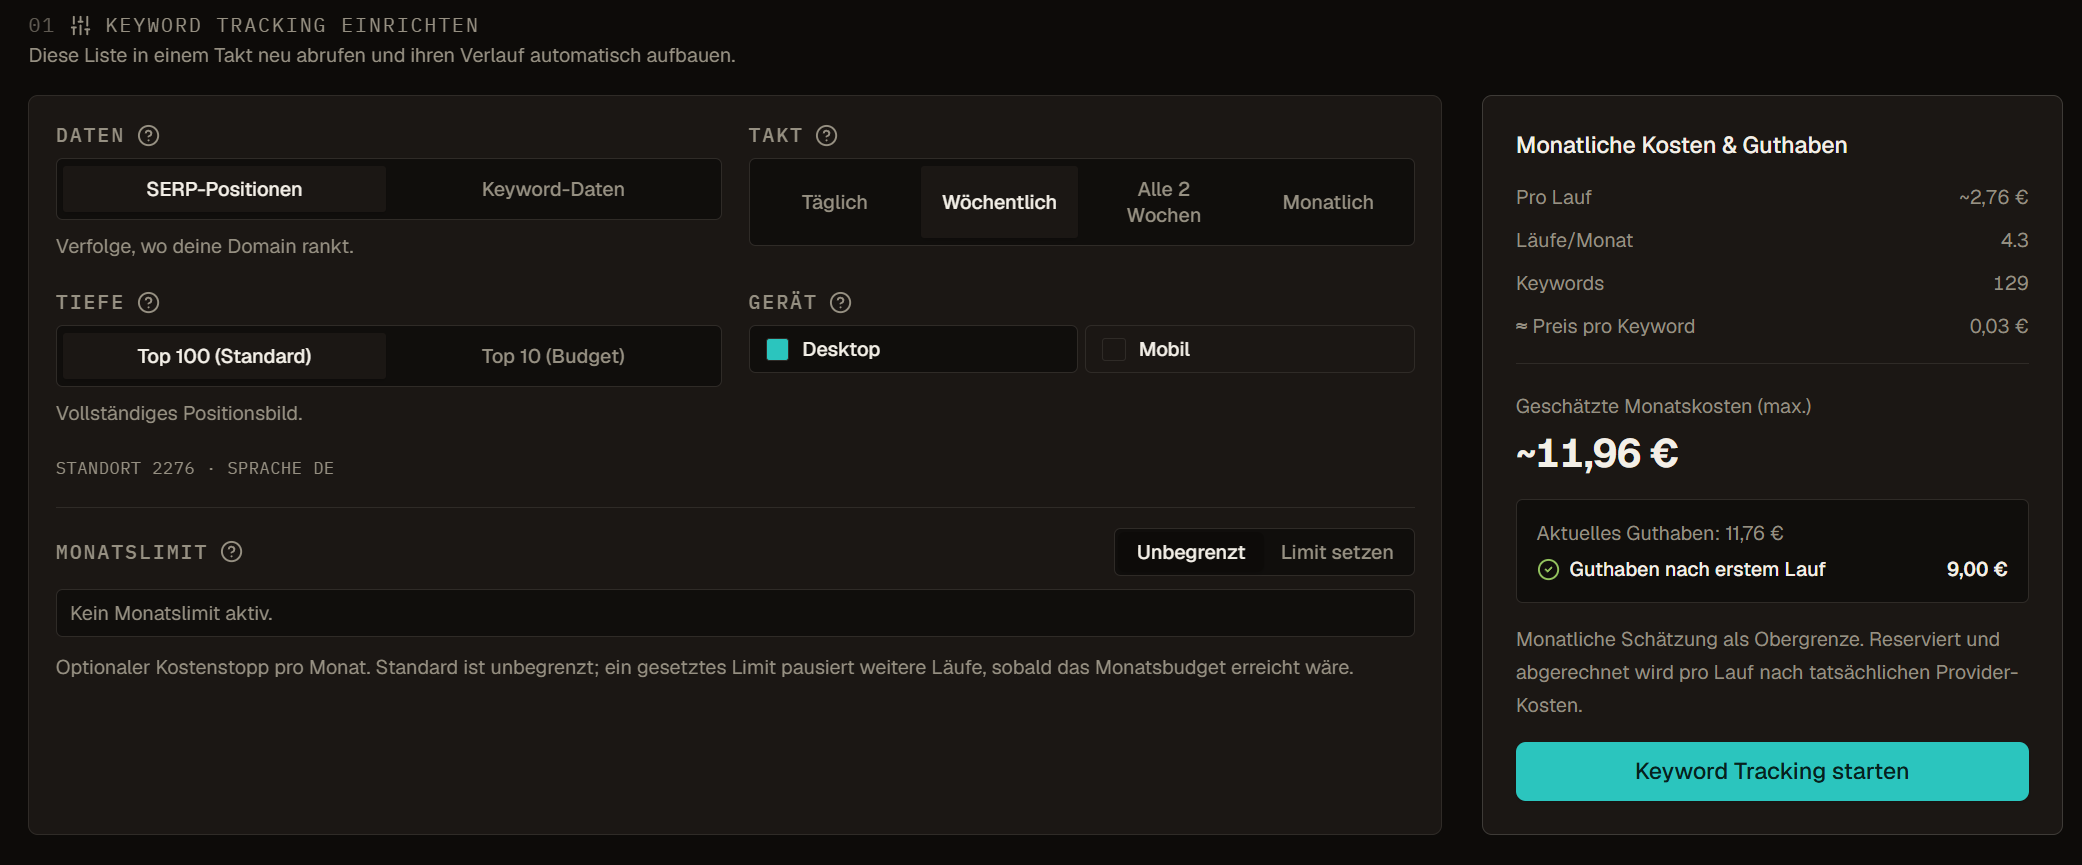
Pour le suivi SERP, choisissez cohorte, lieu, langue, un ou deux appareils pris en charge, profondeur top 10 ou top 100 et cadence. Les cadences possibles sont quotidienne, hebdomadaire, toutes les deux semaines ou mensuelle. Un programme distinct de données de mots-clés peut actualiser des paquets choisis chaque mois ou trimestre.
Le formulaire estime coût par exécution et coût mensuel moyen selon cohorte, appareils, profondeur, paquets et cadence. Il montre le solde et accepte un plafond mensuel optionnel. Illimité ne signifie pas solde illimité, et une estimation n'est pas le débit final. Revérifiez après un changement de taille de liste ou l'ajout d'un appareil.
- Confirmer domaine propre et marché avant la première base.
- Choisir top 10 si la présence en première page suffit, top 100 si une absence plus profonde compte.
- Suivre desktop et mobile séparément dans le programme lorsque les deux contextes importent.
- Nommer une cohorte de liste par objectif, marché et responsabilité de revue.
- Fixer le plafond selon la valeur attendue de la revue, pas selon le maximum du curseur.
- Créer les contextes semblables consciemment, car les doublons actifs exacts sont refusés.
Avant de répéter les mesures, vérifiez les calendriers et coûts du suivi pour le groupe de mots-clés choisi.
Création, exécution manuelle, cadence et cycle de vie sont distincts
La création stocke une prochaine date future et l'interface lance la première base par le chemin manuel. Les exécutions suivantes sont réclamées selon la cadence. Exécuter maintenant emploie la file normale; un programme SERP peut proposer une file plus rapide, estimée séparément, pour cette seule fois. Aucun travail ne démarre si le programme est inactif, déjà en cours, hors budget ou sans solde.
Pause arrête les futures réclamations sans détruire le programme. Reprendre le réactive. Terminer l'archive et le retire de l'envoi ordinaire. Les modifications de cohorte, cadence, appareils, profondeur, paquets ou plafond valent pour l'avenir, pas pour le périmètre immuable d'une exécution déjà réclamée.
Lire le tableau de suivi selon son mode d'agrégation
Le tableau d'une liste peut résumer distribution actuelle, position moyenne, mouvements et historique disponible. Jusqu'au seuil historique pris en charge, il agrège les snapshots par mot-clé. Les grandes listes utilisent une projection actuelle depuis les positions dénormalisées afin de garder une lecture bornée sans parcourir tout l'historique.
L'interface signale ce mode de projection. Ne le présentez pas comme un historique agrégé complet. Comparez la même cohorte et le même contexte, indiquez la couverture manquante et ouvrez la chronologie du mot-clé lorsqu'un mouvement agrégé demande une explication.
Le solde et le résultat font partie de la mesure
Chaque exécution payante réclamée réserve le solde estimé avant le travail. Les résultats terminés règlent le coût réel du fournisseur et le reliquat est libéré. Un programme à plusieurs appareils peut créer plusieurs exécutions enfants dans un groupe logique. Sans données, partiel, échec, solde insuffisant et envoi manqué restent des états distincts.
Le journal conserve nombres demandés et obtenus, état final, heure et coût réglé. Un coût nul peut signifier qu'aucune donnée facturable n'a été rendue, pas que le programme est gratuit. Des échecs ou problèmes de solde répétés peuvent le mettre en pause. Examinez le journal au lieu de lire la prochaine date comme une garantie.
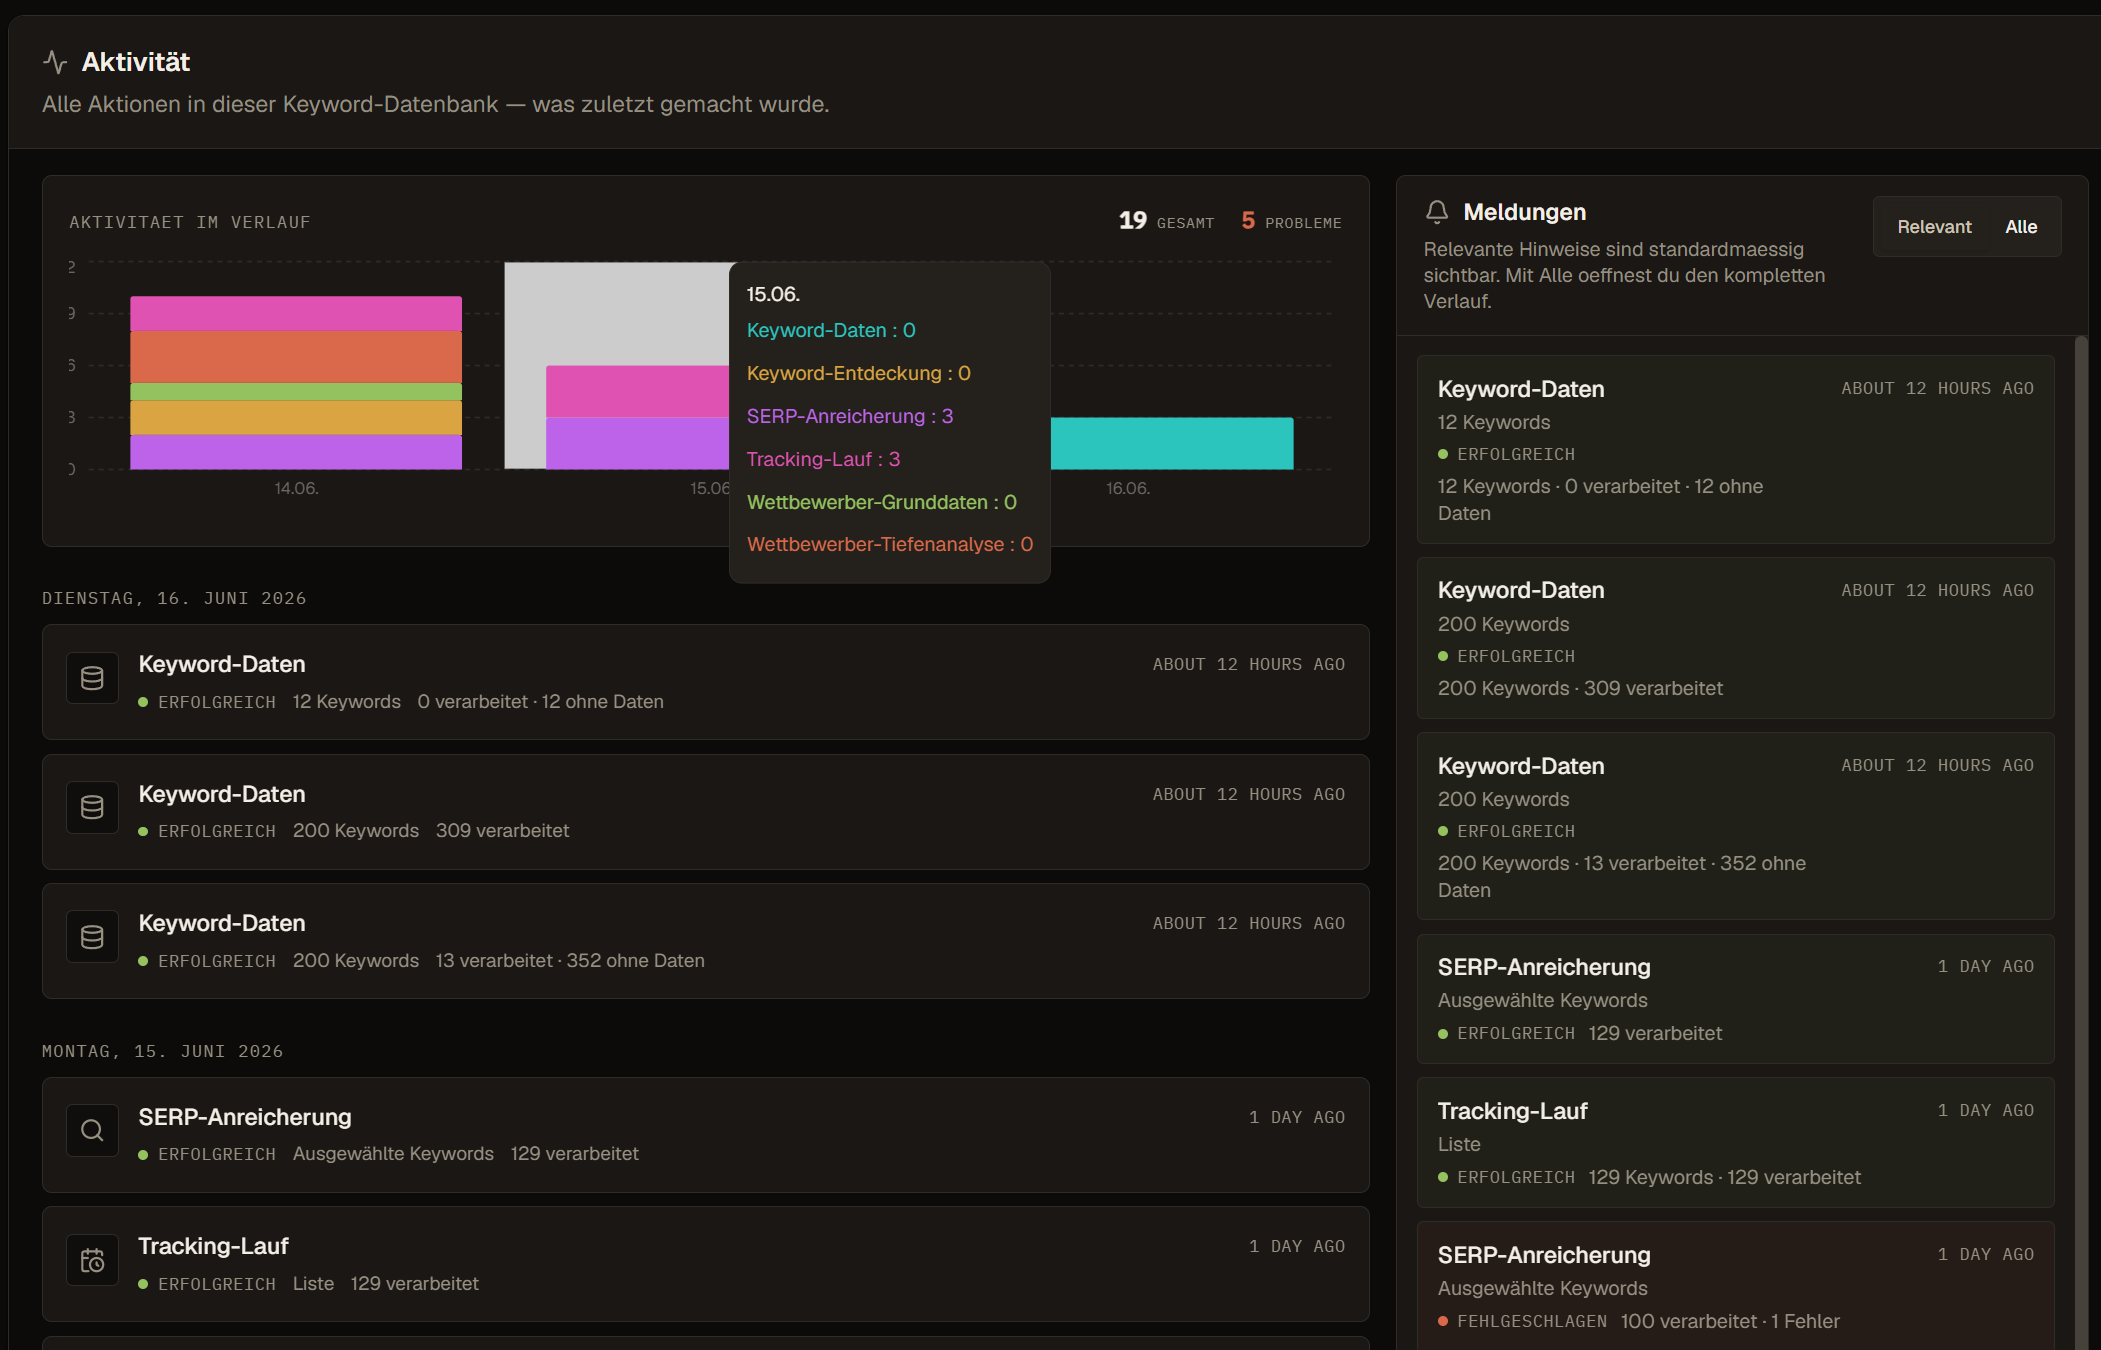
Activité et le journal prouvent l'exécution, pas le clic
Utilisez Activité pour les enrichissements SERP et opérations concurrentielles, puis le journal pour les programmes de suivi. Vérifiez action, périmètre initial, début, fin, lignes demandées, réussies, sans données, en échec, coût et code visible. Queued ou running n'est pas terminé, et partial n'est pas un échec total.
Si une valeur ne change pas, confirmez que le bon travail s'est terminé et que la ligne appartenait au périmètre réclamé. Comparez ensuite source et date. Relancer tout le lot avant ce contrôle peut coûter deux fois, remplacer un contexte utile ou cacher l'échec initial derrière une exécution ultérieure.