
Déplacer les données de mots-clés sans perdre leur sens
Choisissez la liste de destination et ses règles d'appartenance avant d'ajouter des lignes dans un workspace partagé.
L'entrée a une source
L'aperçu est un contrat
La sortie a un destinataire
Traitez l'import et l'export comme deux transferts distincts
L'import transforme des formulations externes et leurs métadonnées éventuelles en enregistrements normalisés qui appartiennent à l'espace de travail actif. L'export lit des enregistrements stockés dans un périmètre choisi et produit un fichier ou un contenu à copier. Dans aucun des deux sens, un nom de métrique semblable ne suffit à prouver que sa définition est identique.
Consignez la source, le marché, l'objectif et la décision attendue avant de déplacer les données. Après un import propre, l'équipe doit pouvoir retrouver l'origine d'un terme. Après un export propre, la personne destinataire doit comprendre ce qui est inclus, la date des observations et une éventuelle troncature sans avoir besoin de votre écran ouvert.
Ajoutez un petit ensemble de requêtes, une par ligne
Utilisez la saisie simple lorsque vous connaissez déjà un petit ensemble de recherches. Collez un terme par ligne et gardez une formulation proche de ce qu'une personne pourrait réellement saisir. Les lignes vides sont ignorées, les espaces superflus sont retirés et les formulations en double sont normalisées avant l'aperçu.
Ne mélangez pas titres d'articles, consignes, commentaires, marchés et mots-clés dans le même champ. La saisie manuelle crée des enregistrements dans l'espace de travail. Elle ne commande pas discrètement toutes les métriques externes. Si vous choisissez Importer et choisir des données, le produit n'ouvre la décision séparée sur le paquet et le prix qu'après l'import.
- Saisissez la requête lisible, pas une note telle que rédiger une landing page pour ce sujet.
- Gardez visibles les contextes de langue et de pays au lieu de les cacher dans des commentaires.
- Séparez les formulations qui regroupent plusieurs tâches de recherche sans rapport.
- Vérifiez orthographe des marques, ponctuation et abréviations ambiguës avant l'import.
- Utilisez un fichier ou un tableau collé lorsque des métadonnées doivent accompagner le terme.
Choisissez l'entrée qui préserve la forme de la source
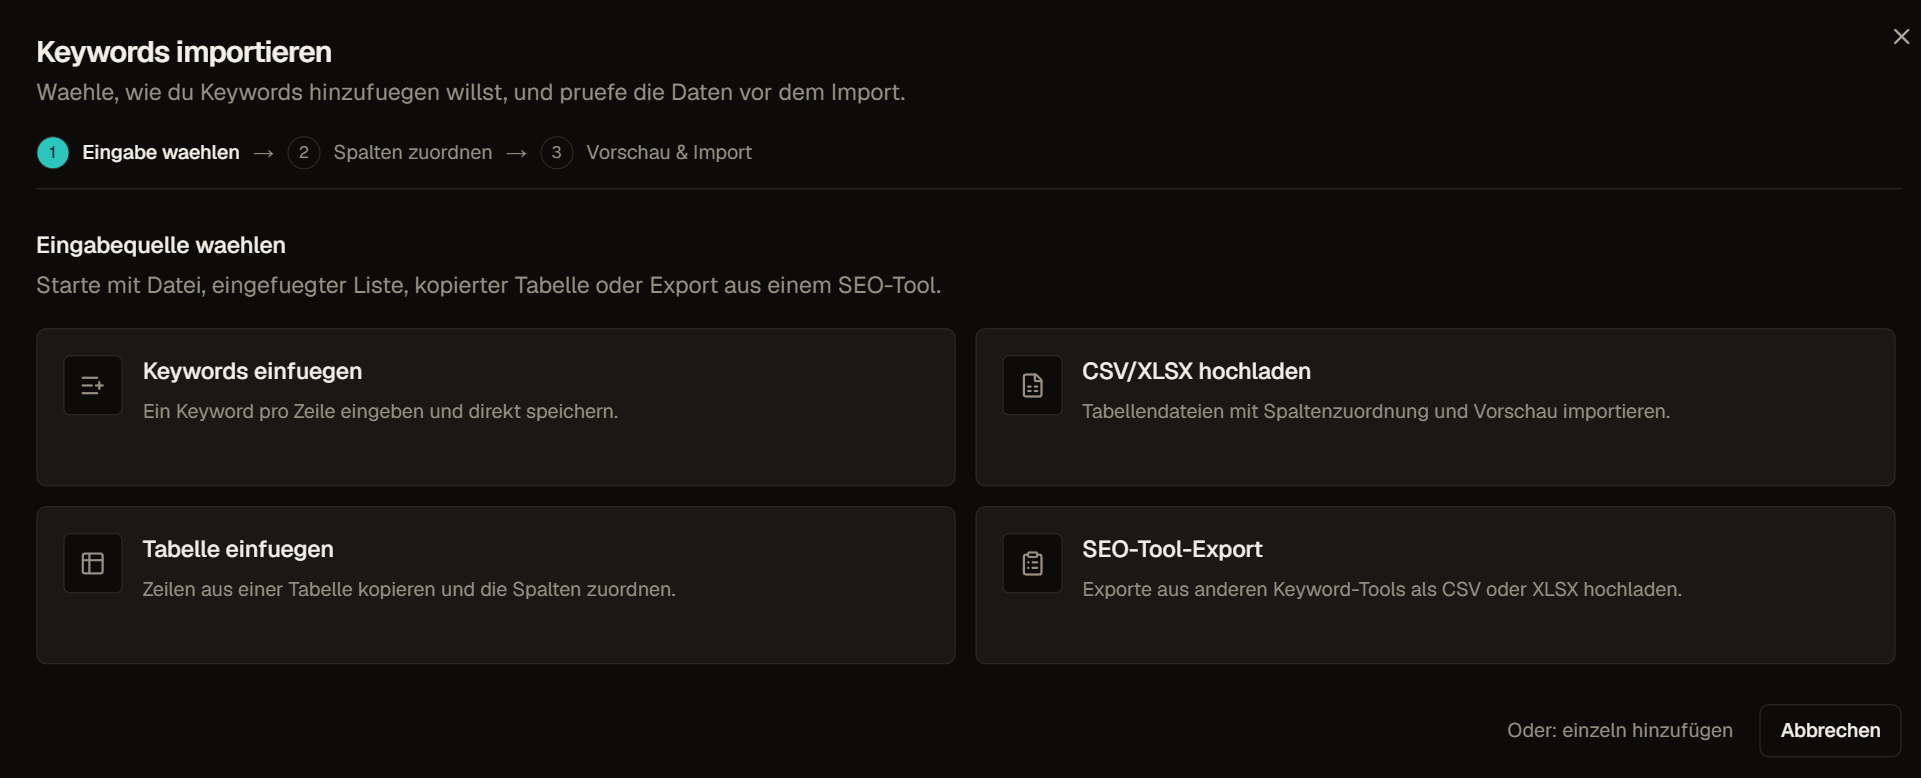
La boîte d'import accepte des lignes de mots-clés, un fichier CSV, TSV, TXT ou XLSX, un tableau collé et un chemin destiné aux exports d'outils SEO. Un envoi accepte actuellement un fichier pris en charge jusqu'à la limite affichée dans l'interface, avec 10 Mo comme limite client par défaut. Un import peut contenir jusqu'à 10 000 mots-clés uniques acceptés.
Les lignes simples ne passent pas par l'association des colonnes. Les tableaux et fichiers conservent leurs lignes pour détecter les en-têtes et associer les champs. Si la première ligne n'est pas correctement reconnue, vérifiez avant de continuer si elle a été traitée comme donnée ou comme en-tête. Un avertissement du parseur n'est pas toujours bloquant, mais il doit être examiné.
| Entrée | Usage |
|---|---|
| Coller des mots-clés | Un mot-clé par ligne, sans métadonnées |
| Envoyer un fichier | CSV, TSV, TXT ou XLSX conservé comme source reproductible |
| Coller un tableau | Lignes copiées depuis un tableur ou une interface de reporting |
| Export d'un outil SEO | Fichier façonné par un fournisseur dont les champs doivent encore être vérifiés |
Si le fichier contient des indicateurs, comparez-les aux définitions des métriques avant de considérer les valeurs importées comme des mesures équivalentes.
Associez d'abord la colonne du mot-clé, puis chaque champ facultatif
La colonne du mot-clé est obligatoire. L'association automatique reconnaît des noms d'en-têtes courants, mais seule l'association visible constitue le contrat à valider. Les rôles facultatifs comprennent tag, liste, langue, pays, Volume, KD, CPC, Competition payante, Competition Index, Intent, bornes d'enchères, nombre de résultats SERP, moyenne des backlinks, moyenne des domaines référents et le champ de rang de liens du fournisseur enregistré sous topTenAvgRank.
N'associez pas une colonne simplement parce que son nom paraît familier. Vérifiez unité, marché, devise, date, fournisseur et convention pour les valeurs absentes. La Competition payante n'est pas la KD organique, le nombre de résultats SERP reste approximatif et topTenAvgRank n'est pas la position Google moyenne. Laissez le champ sans association si sa signification ne peut pas être établie.
La normalisation retire le bruit sans décider de l'intention
L'import retire les espaces superflus, écarte les lignes vides, conserve la première casse lisible et détecte les doublons à partir de la formulation en minuscules. Les termes qui dépassent la limite prise en charge de 200 caractères sont refusés. Les lignes en double dans la même entrée sont fusionnées avant l'aperçu au lieu de créer plusieurs enregistrements.
Cette normalisation ne prouve pas que deux formulations répondent à la même tâche, au même marché ou à la même SERP. Elle ne fusionne pas non plus variantes orthographiques, singulier et pluriel, traductions ou synonymes sur une simple supposition sémantique. Examinez ces relations après le contrôle mécanique des doublons, comme des décisions éditoriales ou de recherche.
Langue, pays, tags et noms de listes ont des fonctions différentes
Une langue associée est normalisée vers un code court reconnu lorsque cela est possible. Le pays consigne le marché et peut reprendre le pays par défaut choisi dans les options d'import. Langue et pays ne sont pas interchangeables. Une même formulation peut appartenir à des environnements de résultats différents en France, en Belgique, au Canada, en Suisse ou dans un autre marché.
Les tags associés deviennent des étiquettes réutilisables dans l'espace. Les noms de listes associés deviennent des instructions d'appartenance. Une destination choisie peut aussi ajouter une liste manuelle existante ou créer une nouvelle liste pour l'ensemble importé. Les tags et listes absents peuvent être créés pendant l'import. Vérifiez leur nom, car une faute peut devenir un objet durable dans l'espace plutôt qu'une simple cellule erronée.
- Les cellules de tags acceptent plusieurs libellés séparés par des virgules ou des points-virgules.
- Les cellules de listes utilisent des virgules entre les noms, ce qui permet de conserver un point-virgule dans un nom.
- Le sélecteur de destination propose des listes manuelles existantes, pas l'appartenance calculée d'une liste intelligente.
- Sans liste de destination, les enregistrements restent dans l'inventaire de l'espace sans recevoir cette appartenance supplémentaire.
- Le pays associé à une ligne est prioritaire sur le pays par défaut pour cette ligne.
Utilisez l'aperçu comme contrat d'import
L'aperçu indique les lignes examinées, les enregistrements acceptés, les doublons dans l'entrée, les éléments invalides et les doublons déjà connus dans l'espace. Il peut afficher pays, tags, listes et état de doublon lorsqu'ils sont disponibles. Ne sélectionnez avant validation que les lignes qui appartiennent réellement à ce transfert.
Si le contrôle des doublons de l'espace est incomplet, l'aperçu reste utilisable mais ne peut pas désélectionner avec certitude chaque enregistrement existant. Relancez le contrôle ou réduisez le lot lorsque le traitement des doublons est important. Un compteur nul pour les doublons internes au fichier ne prouve pas que l'espace ne contient pas les mêmes termes.
Décidez si les enregistrements existants restent intacts ou reçoivent l'import
Ignorez les enregistrements existants lorsque le fichier ne doit ajouter que de nouveaux termes normalisés. Incluez-les lorsque l'import vérifié est autorisé à mettre à jour les champs pris en charge et à appliquer le chemin de métadonnées choisi. Des lignes avec métriques importées peuvent modifier des enregistrements existants. Il s'agit donc d'une décision sur les données, pas d'une préférence d'affichage des doublons.
Un doublon ne crée pas un second enregistrement actif. Vérifiez dans le bilan les nombres importés, ignorés, en double et en erreur. Si l'état actuel des métriques doit être conservé, retirez les doublons de la sélection au lieu de supposer qu'une source ultérieure gagnera automatiquement d'une manière compréhensible par l'équipe destinataire.
Les métriques importées sont des données source, pas de nouvelles observations Crawl Foundry
Les métriques associées peuvent être stockées sans acheter une autre requête externe. Cela préserve un contexte de migration utile, mais la valeur importée reste soumise à la définition et à la date du fichier source. L'import ne peut pas reconstituer à partir du nombre seul un fournisseur, une devise, un type de correspondance, un marché ou une date de collecte absents.
Conservez le fichier source et sa documentation pour les migrations importantes. Ne comparez les métriques importées qu'après avoir aligné les définitions. Demandez séparément des données actuelles prises en charge par Crawl Foundry lorsqu'une décision exige le contrat fournisseur présent et une date de collecte visible. Ne présentez jamais une valeur importée vide comme un zéro.
Importez d'abord, puis prenez une décision séparée sur les données payantes
Importer écrit uniquement les enregistrements vérifiés et les métadonnées prises en charge. Importer et choisir des données effectue le même import, puis ouvre le choix du paquet d'enrichissement et de son prix pour les mots-clés importés. Aucun paquet payant caché n'est commandé pendant l'analyse du fichier.
Lorsque le fichier contient déjà des colonnes de métriques payantes prises en charge, le flux peut conserver ce contexte importé sans ouvrir immédiatement un autre choix de données. Si vous demandez plus tard un enrichissement, confirmez périmètre, pays, paquets, estimation et solde. Le traitement de données qui en résulte possède ses propres états de progression et de fin, séparés du bilan d'import.
Vérifiez la fin avant d'utiliser l'ensemble importé
Le résultat immédiat distingue enregistrements importés, ignorés, en double et en erreur. Un chemin volumineux ou associé à un enrichissement peut aussi afficher sa progression dans un traitement. Comparez les nombres finaux avec l'aperçu sélectionné et les listes de destination avant de lancer une analyse, un autre enrichissement ou un export.
Si l'affectation des métadonnées échoue pour certaines lignes, ne supposez ni que les enregistrements de mots-clés ont aussi échoué, ni que chaque liste cible est complète. Examinez le résultat visible, répétez uniquement l'opération concernée lorsque cela est possible et gardez le fichier d'origine. Relancer tout l'import avec les mises à jour autorisées peut modifier des enregistrements déjà réussis.
Choisissez la source de l'export avant son format
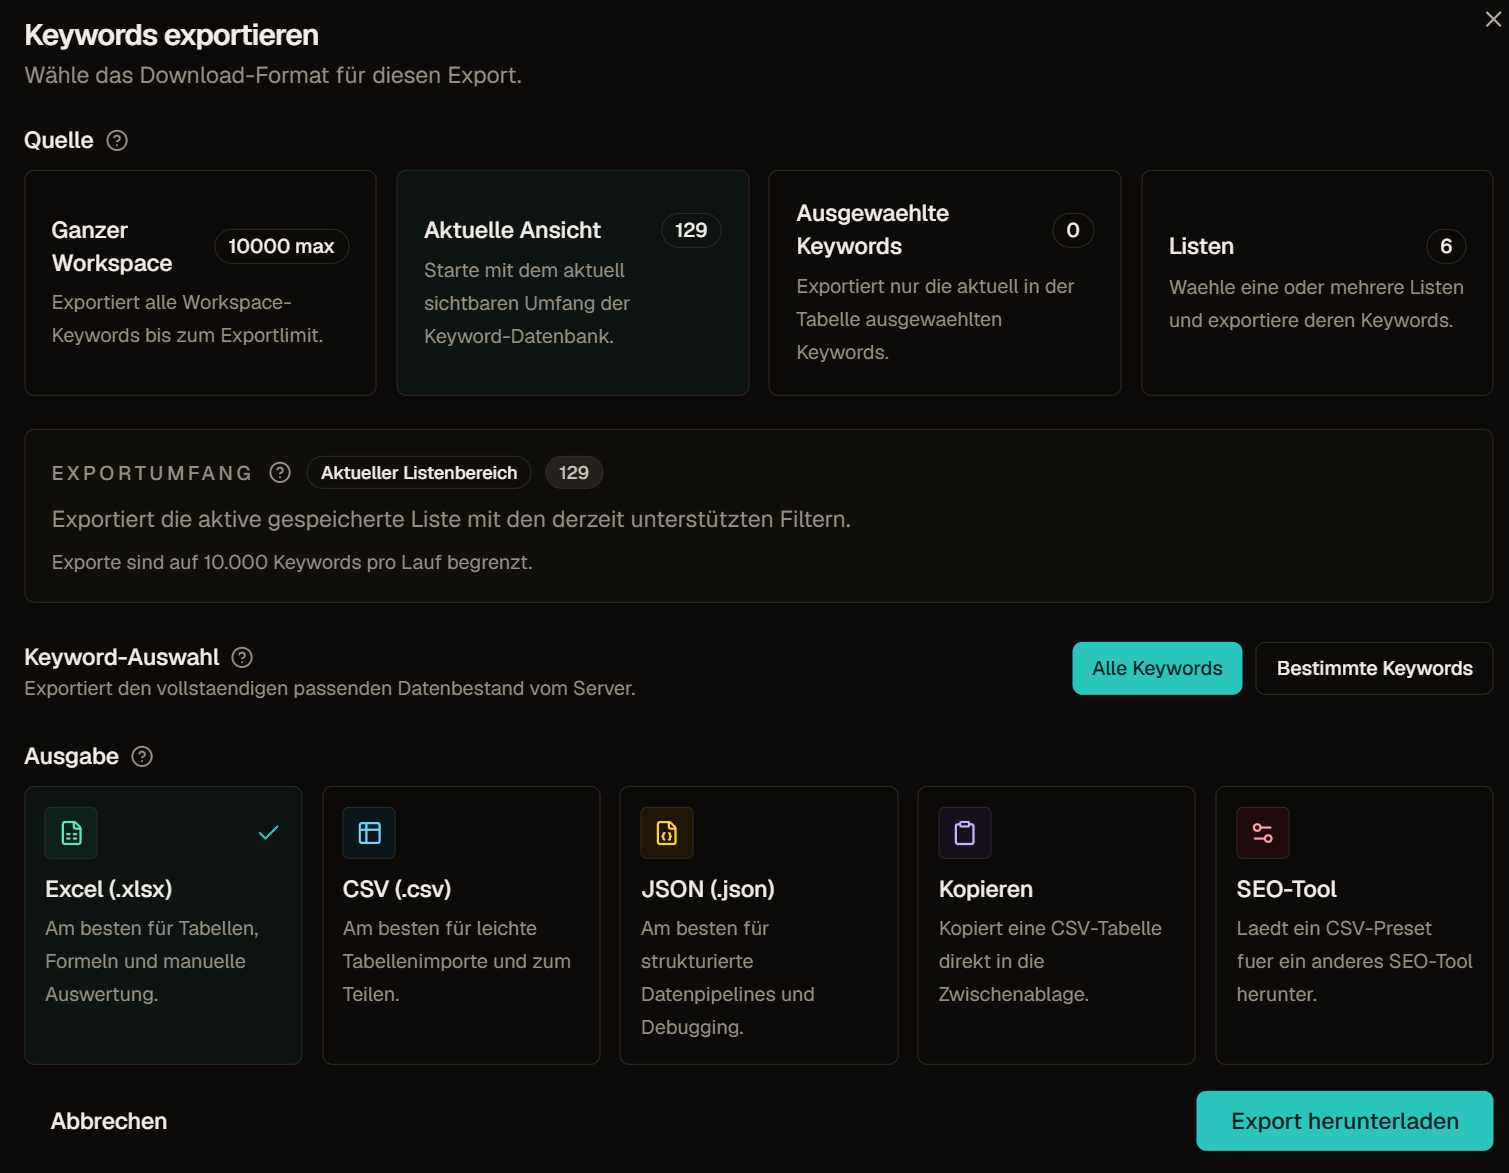
Les sources disponibles sont tout l'espace de travail, le périmètre actuel pris en charge, une sélection explicite de mots-clés ou une ou plusieurs listes. Lorsque des mots-clés sont sélectionnés, la boîte privilégie cette sélection. Un périmètre actuel peut transmettre au serveur les filtres et le tri pris en charge. Un export de listes résout leurs appartenances et peut ajouter les noms des listes aux termes concernés.
La source détermine les lignes. Le preset de sortie détermine le schéma de colonnes. Les colonnes visibles du tableau ne promettent pas que l'export contiendra exactement ces champs. Masquer une colonne ne la retire pas du schéma par défaut. Lisez le choix de sortie et contrôlez un fichier d'exemple avant de le transmettre.
Pour une transmission ciblée, utilisez les filtres et les colonnes afin d'adapter l'export à la question du destinataire.
Choisissez le format ou le presse-papiers en fonction du destinataire
Les sorties actuelles sont CSV, JSON, XLSX, CSV copié dans le presse-papiers et presets CSV façonnés pour Ahrefs, Semrush ou SISTRIX. Le schéma par défaut constitue le transfert Crawl Foundry large. JSON ajoute des métadonnées sur le nombre de lignes, la troncature et le maximum demandé. XLSX convient à une revue dans un tableur. Le presse-papiers ne convient que si la surface de destination et le nombre de lignes sont maîtrisés.
Les presets d'outils changent les en-têtes et retiennent un ensemble réduit de champs à la forme compatible. Ils ne téléversent rien, ne synchronisent aucun compte, ne convertissent pas les définitions propriétaires et ne garantissent pas qu'un fournisseur acceptera toutes les futures versions du format. Traitez-les comme des téléchargements façonnés et testez un petit fichier dans le système destinataire.
| Sortie | Limite importante |
|---|---|
| CSV par défaut | Schéma Crawl Foundry large et fixe, valeurs inconnues laissées vides |
| JSON | Lignes et métadonnées d'export pour un contrôle programmatique |
| XLSX | Fichier de tableur, pas de connexion à un classeur synchronisé |
| Presse-papiers | Texte CSV issu du même chemin d'export côté serveur |
| Preset d'outil | Champs renommés et réduits, sans conversion de métriques ni synchronisation |
Lisez les champs par leur définition, pas seulement par leur en-tête
Le fichier par défaut peut contenir formulation du mot-clé, tags, noms des listes manuelles, langue, pays, famille de source, session de recherche, statut de processus, métriques centrales, champs de recherche payante, agrégats de liens, Data Health, SERP Dynamics et nombre d'échantillons, Visibility limitée au périmètre, dates de première apparition et de collecte, tendances de volume et Chances. Les valeurs inconnues restent vides au lieu de devenir zéro.
Plusieurs champs exigent leur référence métrique. `top_ten_avg_rank` est le rang de liens du fournisseur, `visibility_clicks` une estimation modélisée pour votre domaine, `chances_score` utilise seulement Volume et KD stockés, et `status_id` est une étiquette de l'espace, pas une preuve de fin. Joignez source et dates dès que le destinataire pourrait sinon lire ces champs comme des faits actuels.
Chaque export est plafonné et doit signaler sa troncature
Un export contient actuellement au maximum 10 000 lignes. La réponse indique le nombre de lignes et si le résultat a été tronqué. Un téléchargement réussi peut donc rester incomplet lorsque la source correspond à davantage d'enregistrements.
Découpez un inventaire plus grand en listes nommées ou filtres mutuellement exclusifs et consignez chaque partie. Gardez le même tri et le même preset de champs, puis contrôlez les chevauchements avant de les réunir. Ne présentez jamais plusieurs fichiers plafonnés comme une base complète tant que leurs périmètres ne correspondent pas au total de la source.
Examinez le fichier comme le ferait son destinataire
Ouvrez la sortie avant de la remettre. Vérifiez date du nom de fichier, nombre de lignes, état de troncature, périmètre source, tri, annotations de listes, pays, dates de données, valeurs vides et éventuels identifiants internes de statut ou de session. Les cellules CSV qui commencent par des caractères de formule sont échappées pour une ouverture plus sûre, mais le destinataire reste responsable de la manipulation du fichier et des accès.
Ne qualifiez pas un export de prêt pour un client simplement parce que le téléchargement a fonctionné. Le schéma large peut révéler des champs opérationnels utiles en interne mais déroutants hors de l'équipe. Choisissez la source la plus étroite et un preset adapté, expliquez les définitions et joignez la décision ou la question que le fichier doit éclairer.