
Mueve datos de palabras clave sin perder su significado
Elige la lista de destino y sus reglas de inclusión antes de añadir filas a un workspace compartido.
La entrada tiene una fuente
La vista previa es un contrato
La salida tiene un receptor
Trata importación y exportación como dos entregas distintas
La importación convierte términos externos y metadatos opcionales en registros normalizados que pertenecen al espacio de trabajo activo. La exportación lee registros guardados dentro de un alcance elegido y genera un archivo o contenido para el portapapeles. Ninguna dirección demuestra que dos métricas con nombres parecidos compartan la misma definición.
Anota fuente, mercado, propósito y decisión receptora antes de mover los datos. Una importación limpia debe permitir que el equipo recupere el origen de cada término. Una exportación limpia debe permitir que quien la recibe entienda qué incluye, cuándo se recogieron los datos y si el archivo está truncado sin necesitar tu pantalla abierta.
Añade un conjunto corto de consultas, una por línea
Usa la entrada sencilla cuando ya conoces un conjunto pequeño de búsquedas. Pega un término por línea y mantén la redacción cerca de algo que una persona podría buscar de verdad. Las líneas vacías se ignoran, se elimina el espacio sobrante y la redacción duplicada se normaliza antes de la vista previa.
No mezcles títulos de artículos, instrucciones, comentarios, mercados y palabras clave en el mismo campo. La entrada manual crea registros en el espacio. No solicita silenciosamente todas las métricas externas. Si eliges Importar y elegir datos, el producto abre una decisión separada sobre paquete y precio después de importar los registros.
- Usa la consulta legible, no una nota como escribir una landing page para esto.
- Mantén visibles los distintos contextos de idioma o país en lugar de esconderlos en comentarios.
- Separa frases que contengan varias tareas de búsqueda sin relación.
- Revisa marcas, puntuación y abreviaturas ambiguas antes de importar.
- Usa un archivo o una tabla pegada cuando el término deba conservar metadatos.
Elige el método que conserve la forma de la fuente
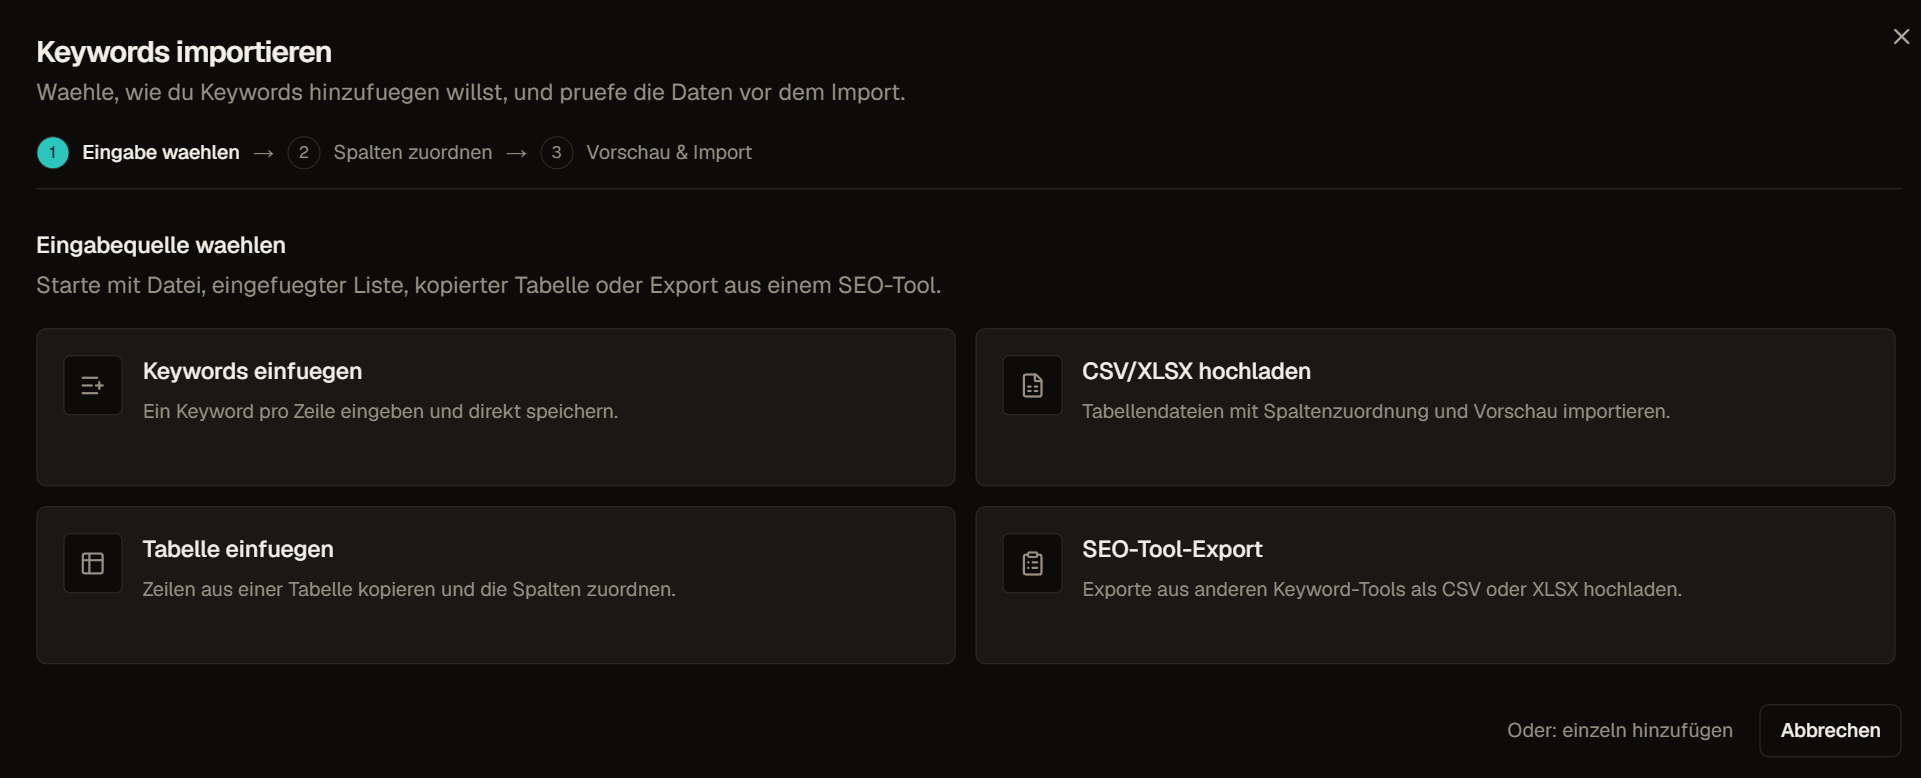
El cuadro de importación admite líneas simples, carga de archivos CSV, TSV, TXT o XLSX, una tabla pegada y una vía para exportaciones de herramientas SEO. Cada carga admite actualmente un archivo compatible hasta el límite que muestra la interfaz, con 10 MB como límite predeterminado en el cliente. Una importación puede contener hasta 10.000 palabras clave únicas aceptadas.
Las líneas simples no pasan por el mapeo de columnas. Las tablas y los archivos conservan sus filas para detectar cabeceras y asignar campos. Si la primera fila no se reconoce bien, comprueba antes de continuar si se trató como dato o como cabecera. Un aviso del analizador no siempre es fatal, pero debe formar parte de la revisión.
| Entrada | Cuándo usarla |
|---|---|
| Pegar palabras clave | Una palabra clave por línea sin metadatos |
| Subir archivo | CSV, TSV, TXT o XLSX conservado como fuente reproducible |
| Pegar tabla | Filas copiadas desde una hoja de cálculo o superficie de informes |
| Exportación SEO | Archivo con la forma de un proveedor cuyos campos todavía deben revisarse |
Si el archivo incluye métricas, compáralas con las definiciones de las métricas antes de tratar los valores importados como mediciones equivalentes.
Mapea primero la palabra clave y después cada campo opcional
La columna de palabra clave es obligatoria. El mapeo automático reconoce nombres habituales, pero el contrato que importa es la asignación visible. Los roles opcionales incluyen etiqueta, lista, idioma, país, Volume, KD, CPC, Competition de pago, Competition Index, Intent, límites de puja, cantidad de resultados SERP, media de backlinks, media de dominios de referencia y el campo de rango de enlaces del proveedor guardado internamente como topTenAvgRank.
No asignes una columna solo porque su nombre resulte familiar. Comprueba unidad, mercado, moneda, fecha, proveedor y convención para datos ausentes. Competition de pago no es KD orgánica, la cantidad de resultados SERP es aproximada y topTenAvgRank no representa la posición media en Google. Deja un campo sin asignar cuando no puedas establecer su significado.
La normalización elimina ruido, pero no decide la intención de búsqueda
La importación elimina espacios sobrantes, descarta filas vacías, conserva el primer uso legible de mayúsculas y minúsculas y detecta duplicados con la palabra clave en minúsculas. Se rechazan los términos que superan el máximo admitido de 200 caracteres. Las filas duplicadas dentro de la misma entrada se fusionan antes de la vista previa en lugar de convertirse en varios registros.
Esta normalización no demuestra que dos frases respondan a la misma tarea, al mismo mercado o a la misma SERP. Tampoco fusiona por conjetura variantes ortográficas, singular y plural, traducciones o sinónimos. Revisa esas relaciones después del control mecánico de duplicados como decisiones editoriales o de investigación.
Idioma, país, etiquetas y listas cumplen funciones distintas
Un idioma mapeado se normaliza a un código corto reconocido cuando es posible. El país registra el contexto de mercado y puede tomar el país predeterminado elegido en las opciones de importación. Idioma y país no son intercambiables. La misma redacción puede pertenecer a entornos de resultados distintos en España, México, Argentina, Estados Unidos u otro mercado.
Las etiquetas mapeadas se convierten en clasificaciones reutilizables del espacio. Los nombres de listas se convierten en instrucciones de pertenencia. Además, un destino elegido puede añadir una lista manual existente o crear una nueva lista para el conjunto importado. Las etiquetas y listas que no existan pueden crearse durante la importación. Revisa sus nombres, porque un error puede convertirse en un objeto duradero del espacio y no quedarse en una celda defectuosa.
- Las celdas de etiquetas aceptan varios nombres separados por comas o puntos y coma.
- Las celdas de listas separan sus nombres con comas, por lo que un punto y coma puede formar parte del nombre.
- El selector de destino ofrece listas manuales existentes, no pertenencia calculada de listas inteligentes.
- Sin lista de destino, los registros quedan en el inventario del espacio sin esa pertenencia adicional.
- El país mapeado en una fila tiene prioridad sobre el predeterminado para esa fila.
Usa la vista previa como contrato de importación
La vista previa informa de filas inspeccionadas, registros aceptados, duplicados dentro de la entrada, elementos no válidos y duplicados conocidos en el espacio. Cuando están disponibles, muestra país, etiquetas, listas y estado de duplicado. Selecciona antes de confirmar solo las filas que pertenezcan a esta entrega.
Si la comprobación de duplicados del espacio queda incompleta, la vista previa sigue funcionando, pero no puede desmarcar con seguridad cada registro existente. Repite la comprobación o usa un lote menor cuando el tratamiento de duplicados sea importante. Una cifra limpia de duplicados internos no demuestra que el espacio carezca de los mismos términos.
Decide si los registros existentes quedan intactos o reciben la importación
Omite los registros existentes cuando el archivo solo deba añadir términos normalizados nuevos. Inclúyelos cuando la importación revisada pueda actualizar campos admitidos y aplicar la vía de metadatos elegida. Las filas con métricas importadas pueden modificar registros existentes. Por eso es una decisión sobre datos y no una mera preferencia para mostrar duplicados.
Un duplicado no crea un segundo registro activo. Comprueba en el resumen las cantidades importadas, omitidas, duplicadas y con errores. Si debes conservar el estado actual de las métricas, retira las filas duplicadas de la selección en lugar de confiar en que otra fuente ganará después de una forma que el equipo receptor pueda entender.
Las métricas importadas son datos de origen, no observaciones nuevas de Crawl Foundry
Las métricas mapeadas pueden guardarse sin comprar otra solicitud externa. Así se conserva contexto útil de una migración, pero el valor importado sigue sujeto a la definición y fecha del archivo fuente. A partir del número, el importador no puede reconstruir un proveedor, moneda, tipo de concordancia, mercado o fecha de recogida que no estén incluidos.
Conserva el archivo de origen y su documentación en migraciones importantes. Compara métricas importadas solo después de alinear sus definiciones. Solicita por separado datos actuales admitidos por Crawl Foundry cuando una decisión necesite el contrato presente del proveedor y una fecha de recogida visible. No presentes una celda importada vacía como cero.
Importa primero y decide por separado sobre los datos de pago
Importar solo escribe los registros revisados y los metadatos admitidos. Importar y elegir datos ejecuta la misma importación y después abre la selección del paquete de enriquecimiento y su precio para las palabras clave importadas. No contrata un paquete oculto mientras todavía se analiza el archivo.
Cuando el archivo ya contiene columnas de métricas de pago admitidas, el flujo puede conservar ese contexto importado sin abrir inmediatamente otra elección de datos. Si más adelante solicitas enriquecimiento, confirma alcance, país, paquetes, estimación y saldo. El trabajo resultante tiene estados propios de progreso y finalización separados del resumen de importación.
Verifica el resultado antes de usar el conjunto importado
El resultado inmediato separa registros importados, omitidos, duplicados y con errores. Una vía grande o unida a enriquecimiento también puede mostrar progreso mediante su trabajo. Compara las cantidades finales con la vista previa seleccionada y las listas de destino antes de analizar, solicitar más datos o exportar.
Si falla la asignación de metadatos para algunas filas, no supongas que también fallaron los registros de palabras clave ni que todas las listas de destino estén completas. Inspecciona el resultado visible, repite solo la operación afectada cuando sea posible y conserva el archivo original. Repetir toda la importación con actualizaciones habilitadas puede modificar registros que ya habían terminado correctamente.
Elige la fuente de exportación antes que el formato
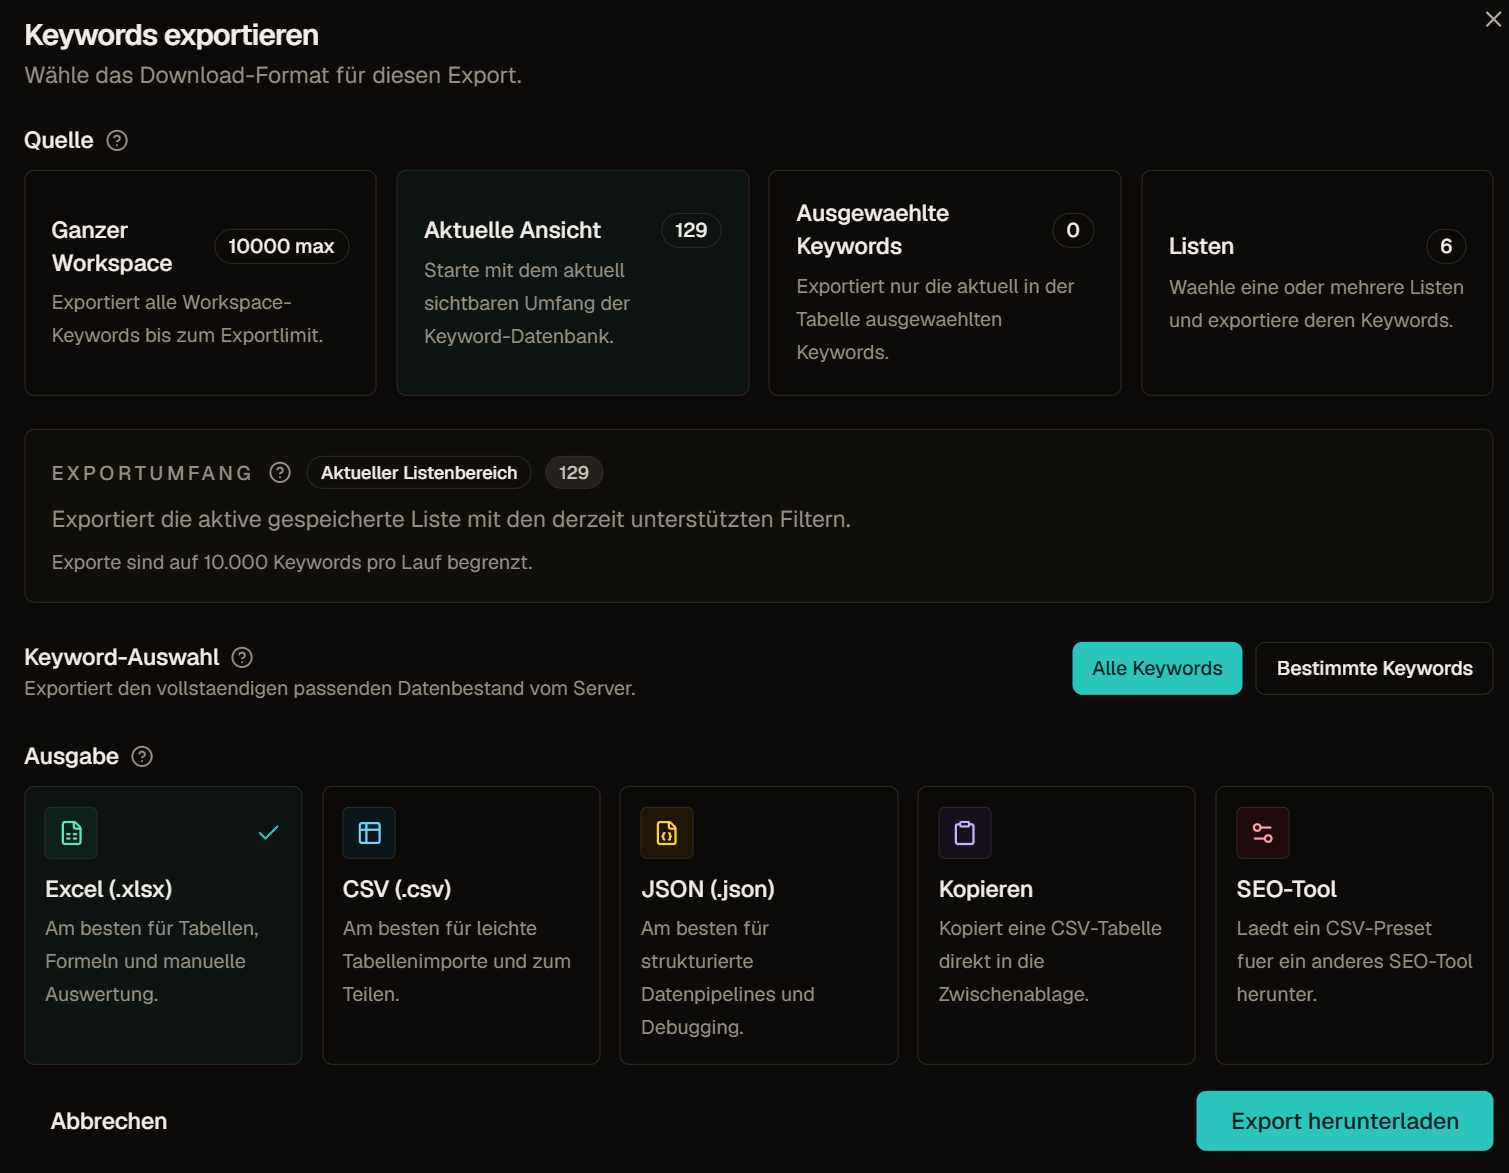
Las fuentes disponibles son todo el espacio, el alcance actual admitido, una selección explícita de palabras clave o una o varias listas. Cuando hay palabras seleccionadas, el cuadro prefiere esa selección. Un alcance actual puede enviar al servidor los filtros y el orden admitidos. Una exportación de listas resuelve sus pertenencias y puede incluir los nombres de lista de los términos elegidos.
La fuente determina las filas. La configuración de salida determina el esquema de columnas. Las columnas visibles en la tabla no prometen que el archivo contenga exactamente esos campos. Ocultar una columna no la elimina del esquema predeterminado. Lee la salida elegida y revisa una muestra antes de entregar el archivo.
Para una entrega precisa, utiliza filtros y columnas para adaptar la exportación a la pregunta del destinatario.
Elige formato o portapapeles para quien va a recibirlo
Las salidas actuales son CSV, JSON, XLSX, CSV en el portapapeles y configuraciones CSV con la forma de Ahrefs, Semrush o SISTRIX. El esquema predeterminado es la entrega amplia de Crawl Foundry. JSON añade metadatos sobre número de filas, truncamiento y máximo solicitado. XLSX es útil para revisar en una hoja de cálculo. El portapapeles solo conviene cuando la superficie receptora y el volumen están controlados.
Las configuraciones de herramientas cambian cabeceras y eligen un conjunto reducido con apariencia compatible. No suben nada, no sincronizan cuentas, no convierten definiciones propietarias ni garantizan que un proveedor acepte todas las futuras revisiones de formato. Trátalas como descargas adaptadas y prueba un archivo pequeño en el sistema receptor.
| Salida | Límite importante |
|---|---|
| CSV predeterminado | Esquema amplio y fijo de Crawl Foundry con desconocidos vacíos |
| JSON | Filas y metadatos de exportación para revisión programática |
| XLSX | Archivo de hoja de cálculo, no conexión a un libro sincronizado |
| Portapapeles | Texto CSV procedente de la misma ruta de exportación del servidor |
| Configuración de herramienta | Campos renombrados y reducidos, sin conversión de métricas ni sincronización |
Lee los campos por su definición y no solo por la cabecera
El archivo predeterminado puede incluir el texto de la palabra clave, etiquetas, nombres de listas manuales, idioma, país, familia de origen, sesión de investigación, estado de flujo, métricas centrales, campos de búsqueda de pago, agregados de enlaces, Data Health, SERP Dynamics y número de muestras, Visibility limitada al alcance, fechas de primera aparición y recogida, tendencias de volumen y Chances. Los valores desconocidos quedan vacíos en lugar de convertirse en cero.
Varios campos necesitan su referencia métrica. `top_ten_avg_rank` es el rango de enlaces del proveedor, `visibility_clicks` una estimación modelada para tu dominio, `chances_score` utiliza solo Volume y KD guardados, y `status_id` es una etiqueta del espacio, no una prueba de finalización. Incluye fuente y fechas cuando quien recibe los datos pueda confundirlos con hechos actuales.
Cada exportación tiene un límite y debe revelar si está truncada
Una exportación contiene actualmente un máximo de 10.000 filas. La respuesta informa del número de filas y de si el resultado está truncado. Por tanto, una descarga correcta puede seguir siendo una parte incompleta cuando la fuente coincide con más registros.
Divide un inventario mayor en listas con nombre o filtros mutuamente excluyentes y registra cada parte. Mantén el mismo orden y configuración de campos, y revisa solapamientos antes de unirlas. No presentes varios archivos limitados como una base completa hasta haber conciliado sus alcances con el total de origen.
Revisa el archivo como lo haría quien lo recibe
Abre la salida antes de entregarla. Comprueba fecha del nombre, número de filas, truncamiento, alcance de origen, orden, anotaciones de listas, país, fechas de datos, valores vacíos e identificadores internos de estado o sesión. Las celdas CSV que empiezan con caracteres de fórmulas se escapan para abrirlas con más seguridad, aunque la persona receptora sigue siendo responsable del acceso y manejo del archivo.
No declares que una exportación está lista para cliente solo porque se descargó. El esquema amplio puede mostrar campos operativos útiles dentro del equipo, pero confusos fuera de él. Elige la fuente más estrecha y una configuración adecuada, explica las definiciones e incluye la decisión o pregunta que el archivo debe ayudar a resolver.