Conecta evidencia SERP, revisión competitiva y seguimiento de posiciones
Ten presentes las definiciones de las métricas de palabras clave para determinar qué puede explicar una captura de resultados.
Una observación SERP fechada
Evidencia competitiva por capas
Una serie de medición controlada
Elige la capa de evidencia antes de solicitar datos
La evidencia SERP, la información competitiva y el seguimiento de posiciones responden a preguntas distintas. Un snapshot solicitado registra qué apareció para una palabra clave en un contexto definido. Las superficies de competidores agregan dominios y, cuando se pide, añaden perfiles o palabras clave posicionadas. El tracking repite una medición controlada y conserva un registro de cada ejecución.
Las capas pueden alimentarse sin convertirse en el mismo conjunto. Un snapshot puede revelar un dominio, el catálogo puede conservarlo para revisión y un seguimiento puede medir después el dominio propio sobre un conjunto aprobado. Cada capa mantiene alcance, fecha, ruta de coste y estados ausentes.
| Pregunta | Superficie adecuada |
|---|---|
| ¿Qué muestra ahora la página de resultados? | Solicitud SERP puntual |
| ¿Qué dominios se repiten en la evidencia del workspace? | Catálogo de competidores y solapamiento SERP |
| ¿Qué presencia orgánica o de pago más amplia tiene un dominio? | Perfil de dominio o análisis profundo solicitado |
| ¿Cómo cambia nuestra posición en un contexto fijo? | Programa de seguimiento de posiciones |
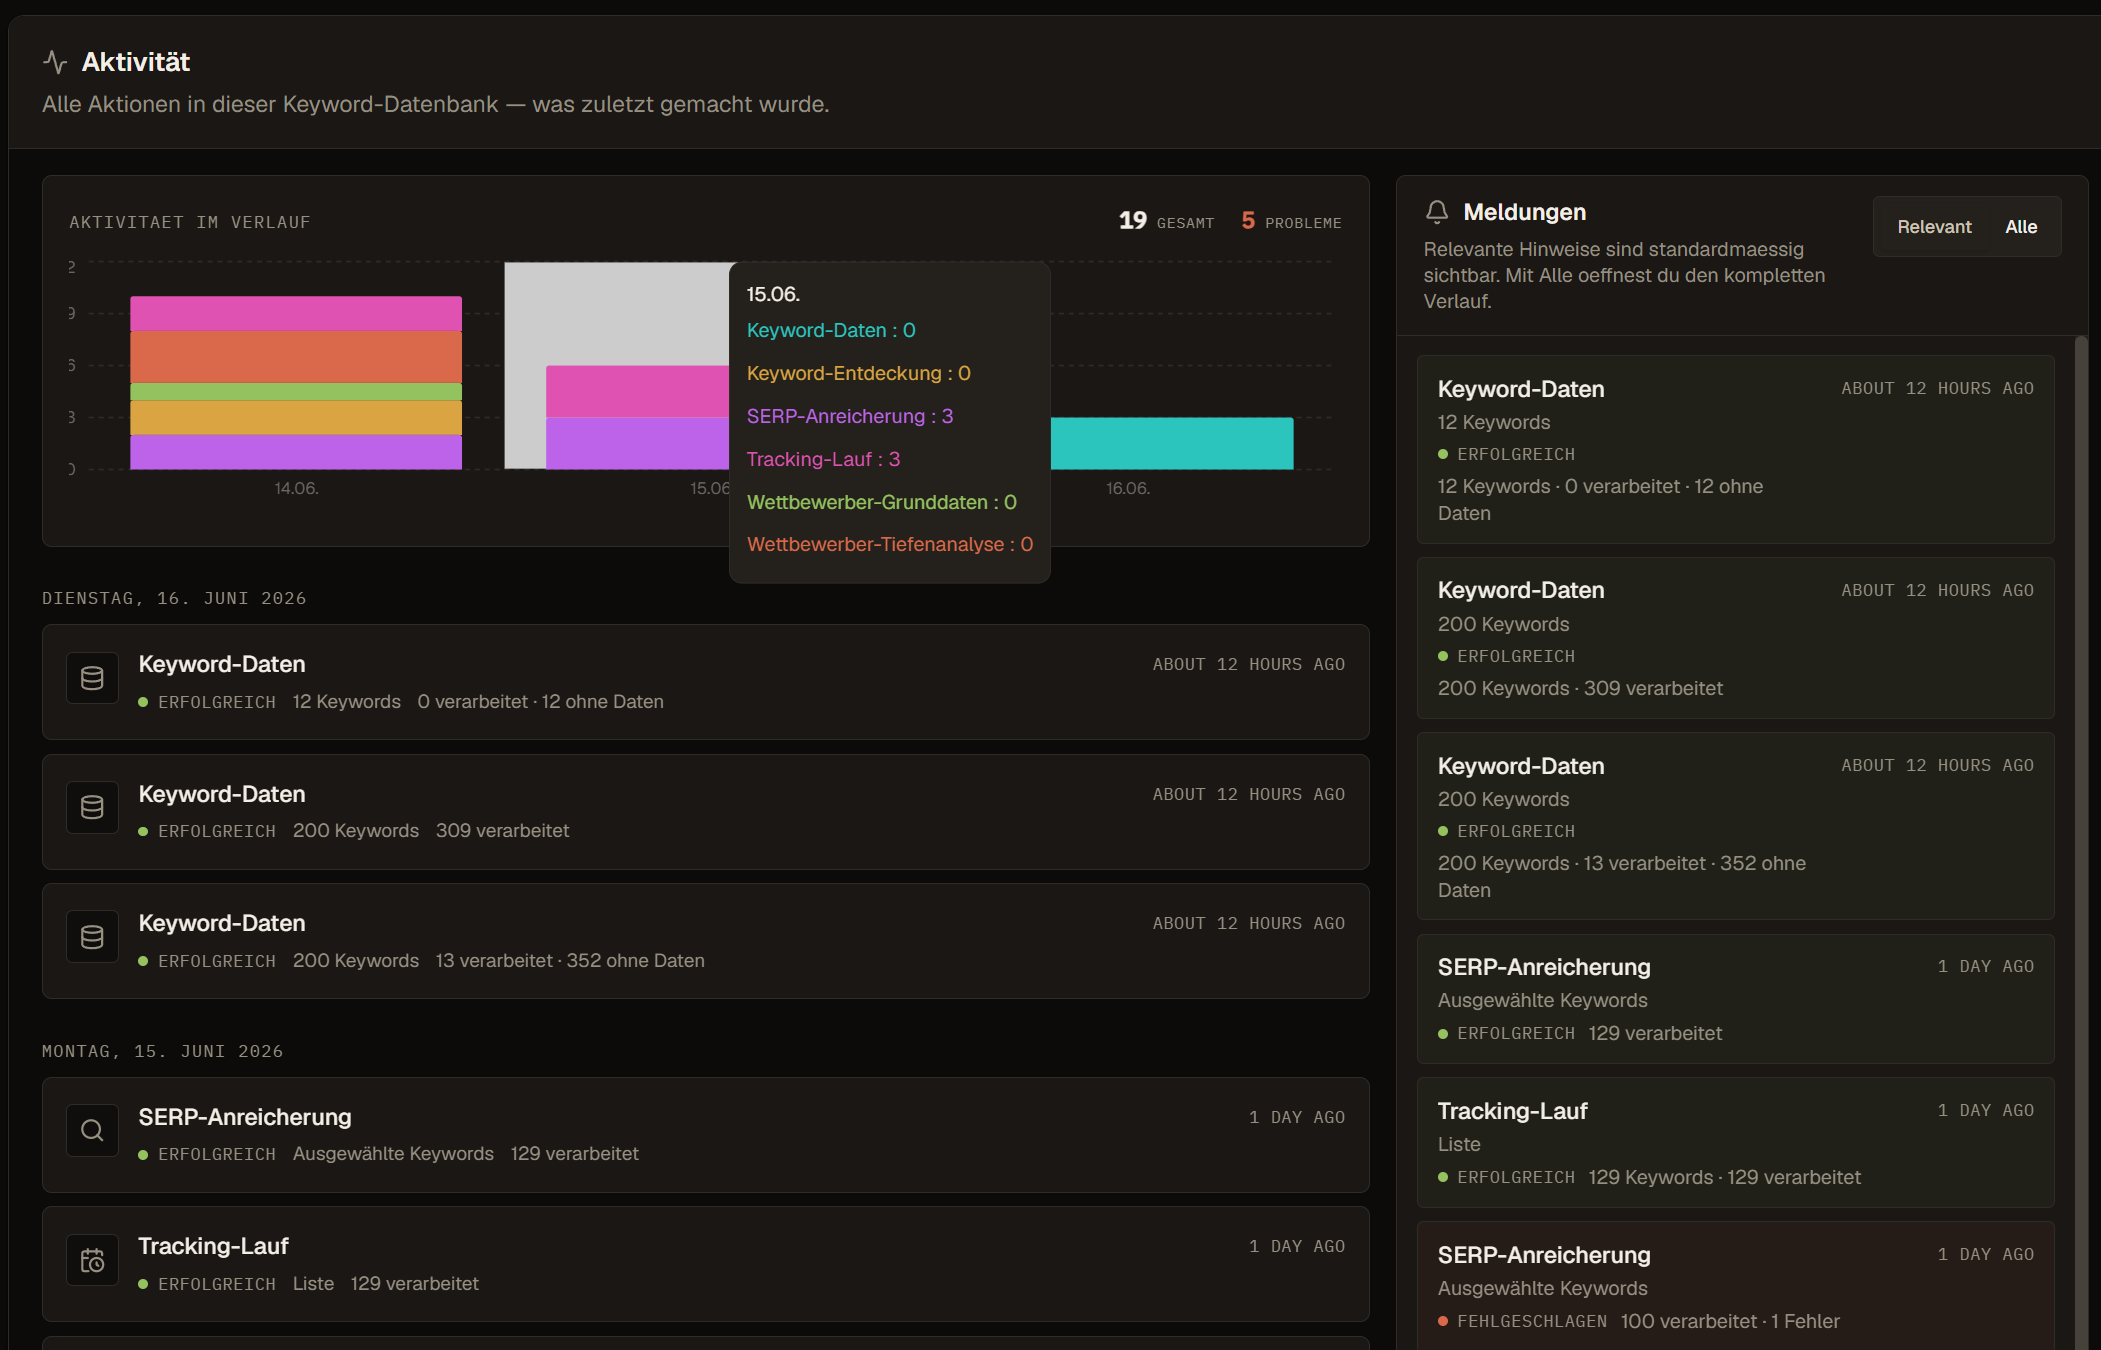
| ¿La solicitud terminó, falló o consumió saldo? | Actividad y registro de ejecuciones |
Solicita una SERP cuando el entorno pueda cambiar la decisión
Una solicitud puntual encaja si necesitas los primeros resultados observados, módulos compatibles, posición del dominio configurado, URL posicionadas o una base fechada para el solapamiento competitivo. Aporta más a una selección ya revisada que a un inventario cuya relevancia aún no está clara.
Es trabajo externo de pago. Confirma palabras normalizadas, ubicación, idioma, modo, filas que aún necesitan datos, resultados en caché, estimación y saldo. La interfaz procesa selecciones grandes en lotes acotados, pero una solicitud aceptada no demuestra que cada término devolviera datos.
- Empieza por filas donde los tipos de resultado o las páginas posicionadas influyen en la página objetivo.
- Usa Solo datos ausentes cuando la selección mezcle filas completas e incompletas.
- Las filas aún frescas en caché se omiten salvo que ordenes sustituirlas.
- Forzar una actualización puede gastar saldo sin cambiar la decisión.
- Después, revisa cantidades solicitadas, completadas, sin datos, fallidas y reutilizadas.
Elige el modo de entrega según plazo y necesidad
Live, Priority y Standard pueden proporcionar los campos SERP actuales, con distinto tiempo y coste estimado. Historical solicita observaciones mensuales de 3, 6, 9 o 12 meses y escribe historial de posiciones. No presenta una página de resultados antigua como actual.
Lee la estimación mostrada porque precio, filas, reutilización de caché y periodo histórico cambian la reserva. Live no es más preciso por ser rápido. Standard no es antiguo por usar una cola asíncrona. Cada observación histórica conserva su fecha cuando se compara con un snapshot actual.
| Modo | Úsalo cuando |
|---|---|
| Live | El resultado actual sea necesario en la revisión activa |
| Priority | Una cola más rápida justifique el suplemento mostrado |
| Standard | El coste importe más que la entrega inmediata |
| Historical | Una serie fechada sea más útil que otro snapshot actual |
SERP Features describe módulos detectados en un snapshot solicitado
El campo puede registrar AI Overview, Featured Snippet, People Also Ask, Local Pack, imágenes, vídeos, Shopping, Knowledge Panel, Site Links, Top Stories, módulos sociales, Jobs y FAQ. Son datos SERP solicitados de forma expresa, no información recopilada automáticamente para todas las palabras clave.
Un indicador significa que el módulo se detectó en esa fecha, mercado, idioma, dispositivo y contexto. No demuestra que tu dominio lo posea ni cuantifica su efecto en clics. Revisa el snapshot y su fecha antes de cambiar una página o estimar potencial de clic.
Para comparar dominios completos en lugar de una sola página de resultados, pasa al análisis competitivo con una pregunta concreta.
Lee los primeros resultados antes de atribuir una causa
Los resultados observados pueden mostrar dominios, URL, posiciones y contexto de enlaces o módulos. Compara tipos de página, tareas de búsqueda, dominios recurrentes y presencia del dominio propio. Un snapshot no explica por qué posiciona una página, si satisface a todas las personas ni qué cambio la desplazaría.
Conserva mercado, idioma, dispositivo, fecha y profundidad con la observación. Un dominio ausente de la profundidad adquirida no está necesariamente ausente de todos los resultados. Mediciones repetidas el mismo día pueden actualizar la fila diaria en vez de crear una serie intradía. No deduzcas la frecuencia por el número de filas.
El catálogo de competidores parte de evidencia del workspace y dominios explícitos
Los dominios observados pueden resumirse por palabras cubiertas, apariciones en top 10, volumen cubierto, mejor posición media, mejor posición y gaps. Un gap existe cuando el competidor aparece en el top 10 y el dominio propio configurado no. El score ordena el catálogo de forma determinista. No es cuota de mercado ni prueba de que ambas empresas disputen los mismos clientes.
Un dominio añadido manualmente puede aparecer antes de tener SERP o perfil de pago. Confirma un competidor real tras revisarlo y oculta un dominio irrelevante cuando corresponda. Medios, directorios, marketplaces y plataformas pueden posicionar con frecuencia sin ser rivales comerciales.
Separa solapamiento SERP, perfil de dominio y análisis profundo
El dossier reúne varias capas sin volverlas intercambiables. El solapamiento procede de los resultados guardados en el workspace. Perfil de dominio es una solicitud agregada de pago con recuentos orgánicos y de pago, tráfico estimado, proxy de coste, movimientos y bandas de posición. No devuelve filas de palabras clave.
Análisis profundo es otra solicitud de pago de palabras posicionadas con profundidad máxima de 100, 500, 1.000, 5.000 o 10.000 filas. La interfaz muestra profundidad pedida, filas guardadas y total del proveedor si existe. Un resultado limitado no es el inventario completo. Tráfico y coste son estimaciones externas, no datos de Analytics o de una cuenta publicitaria.
| Capa del dossier | Qué contiene |
|---|---|
| Desde tus SERP | Solapamiento del workspace, posiciones, URL y contexto de gaps |
| Perfil de dominio | Un snapshot agregado de presencia orgánica y de pago |
| Análisis profundo | Filas posicionadas hasta la profundidad elegida |
| Todas las palabras | Revisión combinada de las filas disponibles |
Los datos competitivos de pago siguen siendo un artefacto de revisión hasta el import
Perfil y Análisis siguen estimación, reserva de saldo, ejecución externa, liquidación del coste real y liberación del resto. Los resultados recientes pueden reutilizarse según la política de caché si no se justifica una ejecución forzada. Running, done y failed pertenecen a la operación solicitada.
Las filas profundas permanecen en el dossier. No se convierten automáticamente en registros de la Base, una lista, un brief o una tarea editorial. Importa solo términos revisados. Los registros normalizados existentes siguen deduplicados y el import conserva procedencia y métricas disponibles sin decidir la lista de destino.
Usa una selección directa o una lista como cohorte de seguimiento
Un programa SERP puede basarse en una selección fija de palabras normalizadas o en una lista con nombre. La selección permanece ligada a esos términos. En una lista, la pertenencia se resuelve al reclamar cada ejecución. Los términos añadidos antes entran y los retirados antes quedan fuera.
Una vez reclamada, la ejecución conserva su cantidad inicial y no persigue cambios hechos mientras trabaja. Usa selección para una cohorte pequeña y fija, y lista cuando los cambios deliberados deban afectar futuras ejecuciones. El programa no asigna por sí solo página, responsable o estado editorial.
Posición es una observación fechada para un dominio y contexto SERP
Posición es el último ranking orgánico guardado para el dominio propio, palabra clave, lugar, idioma, dispositivo, profundidad y fecha disponibles. Una celda vacía puede indicar que no hubo medición, que no apareció en la profundidad adquirida, que faltan datos o que no se configuró dominio propio. No es la posición cero.
Compara solo contextos compatibles. Una observación desktop de un país no es el ranking mobile en otro. El campo registra dónde apareció el dominio. No explica el movimiento, el tráfico ni si la URL posicionada es la página que quería el equipo.
Position Change compara dos observaciones utilizables
El campo compara la posición actual con la observación utilizable anterior en el mismo contexto. Como un número menor es mejor, lee dirección, valor previo y ambas fechas. Si no existe base anterior, el cambio queda desconocido y no se convierte en cero.
El movimiento puede venir de volatilidad normal, otra URL, un resultado perdido, una laguna de medición o una evolución real. Revisa observaciones, SERP Dynamics, URL, módulos y eventos del sitio antes de atribuir una causa o abrir trabajo.
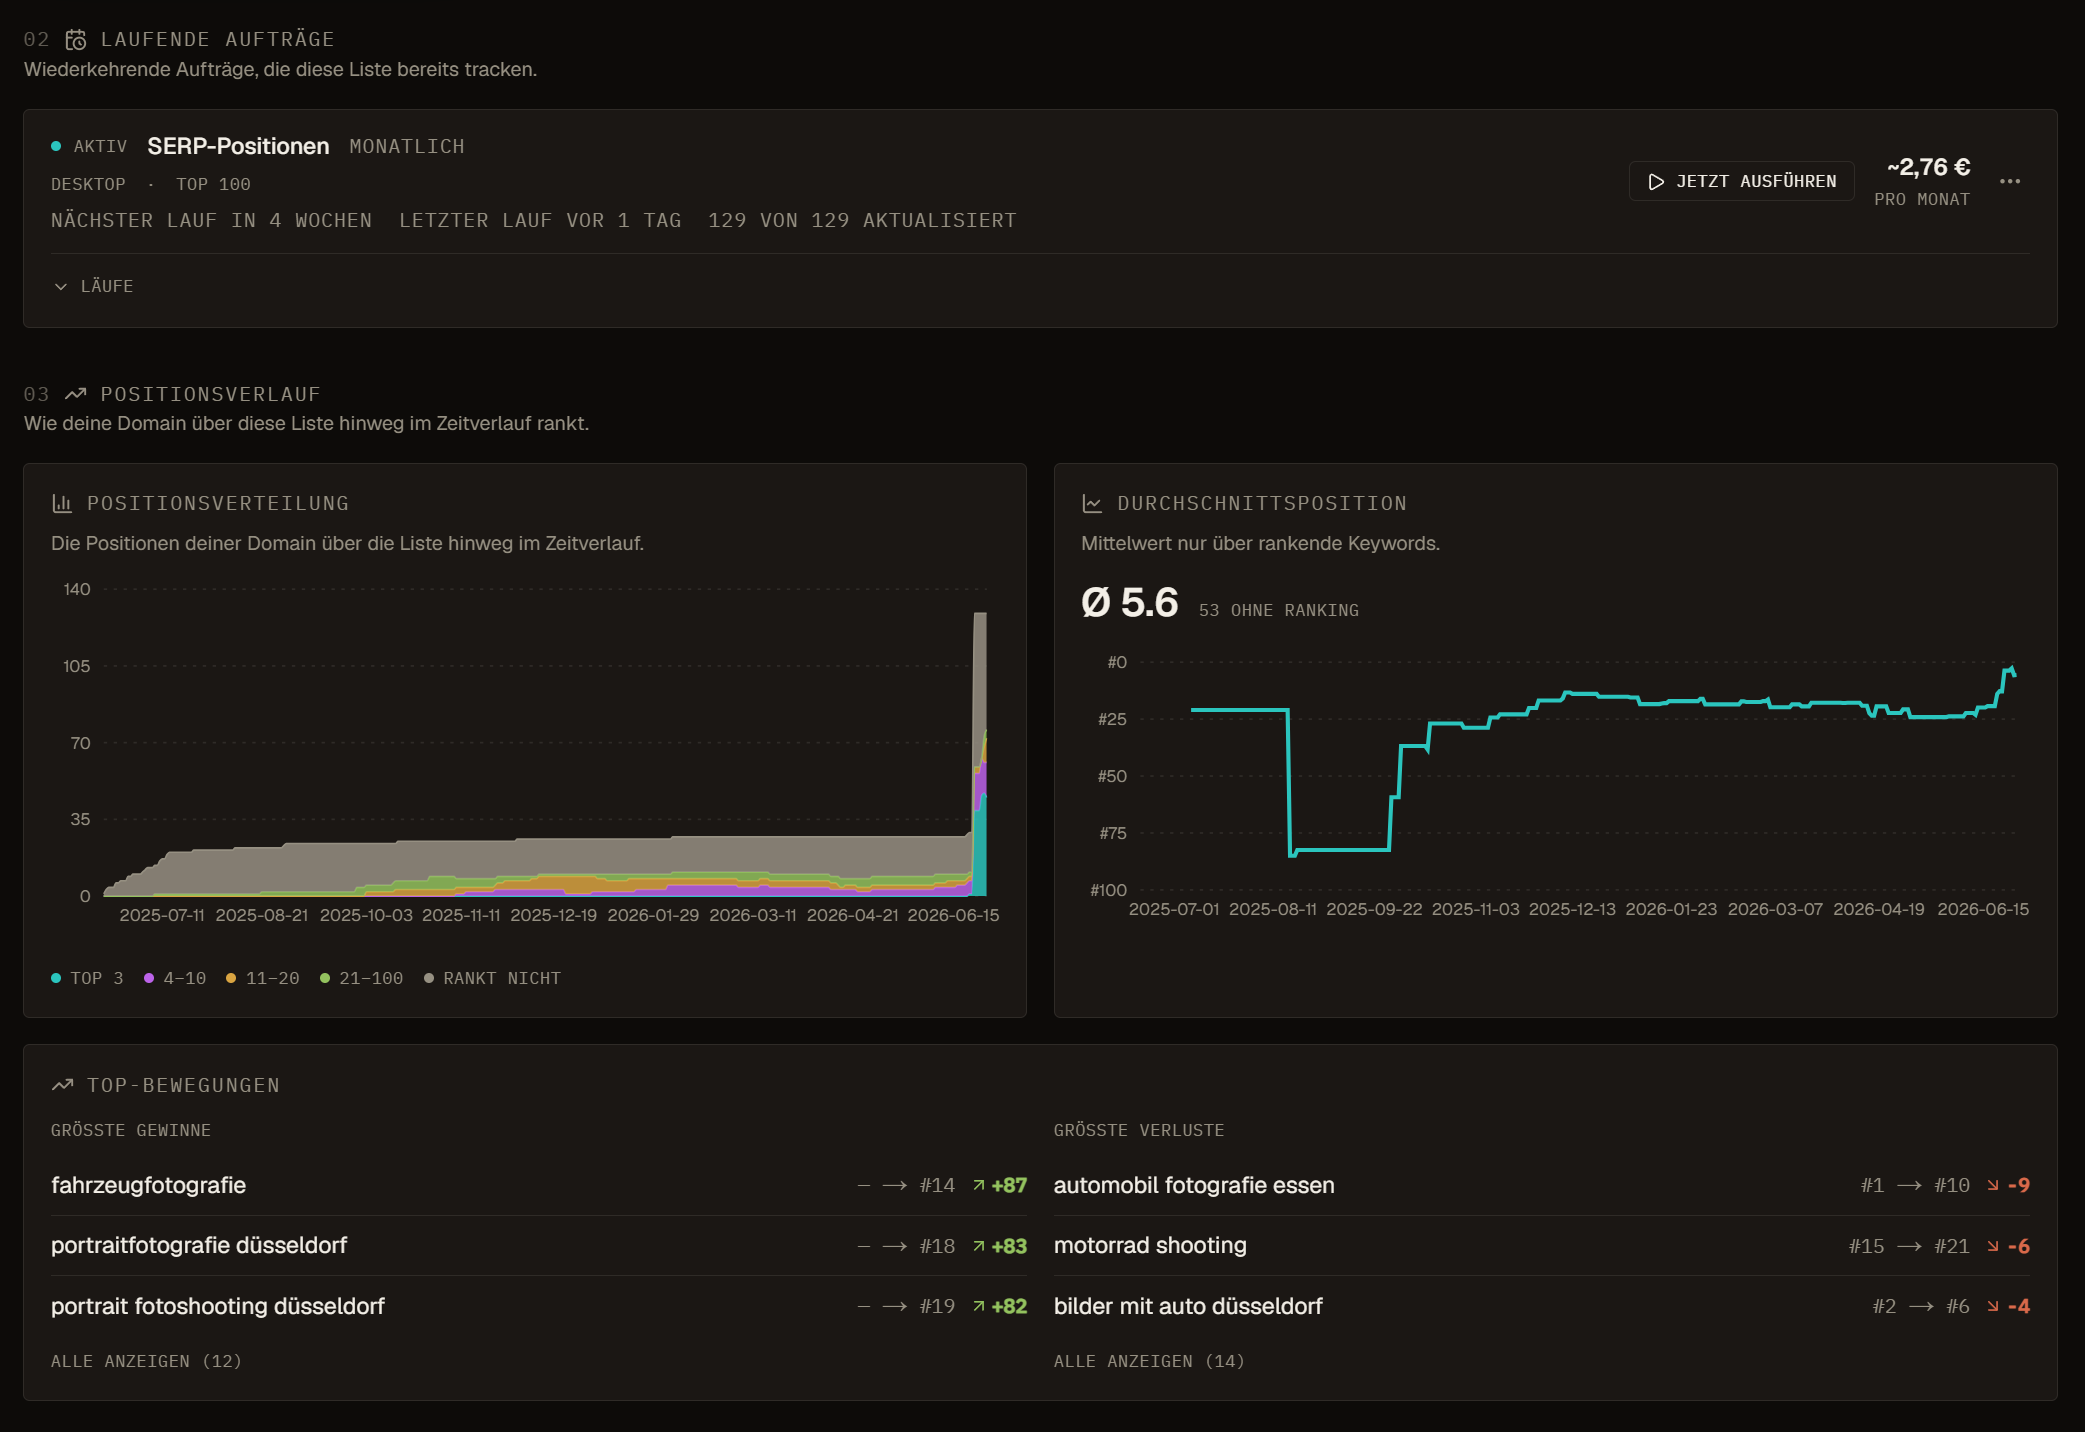
Position Trend muestra la forma de la serie guardada
La tendencia distingue un salto aislado de una secuencia de ganancias, pérdidas, giros o huecos. Se construye con snapshots adquiridos para la palabra clave y el dominio configurado. Los días ausentes no se rellenan como posiciones sin cambios.
Usa la línea para elegir casos que merecen una cronología detallada. No demuestra el efecto de una publicación, actualización, corrección técnica o campaña de enlaces. Alinea los puntos con eventos fechados y comprueba si la URL posicionada siguió siendo la misma.
Position History separa observaciones actuales, programadas y retrospectivas
Solicitudes puntuales, tracking programado y backfills históricos pueden escribir snapshots fechados con su fuente. Los deltas históricos comparan la última observación con un punto utilizable cercano a 3, 6, 9 o 12 meses. Sin base comparable permanecen vacíos.
Los dominios del top 10 pueden aparecer mientras sigan dentro del top 10 observado, mientras los dominios seguidos de forma explícita conservan huecos si no se encuentra posición. Los gráficos también pueden modelar clics o valor mediante volumen y una curva fija. No son sesiones de Analytics ni ingresos.
Un programa de seguimiento necesita un contrato reproducible
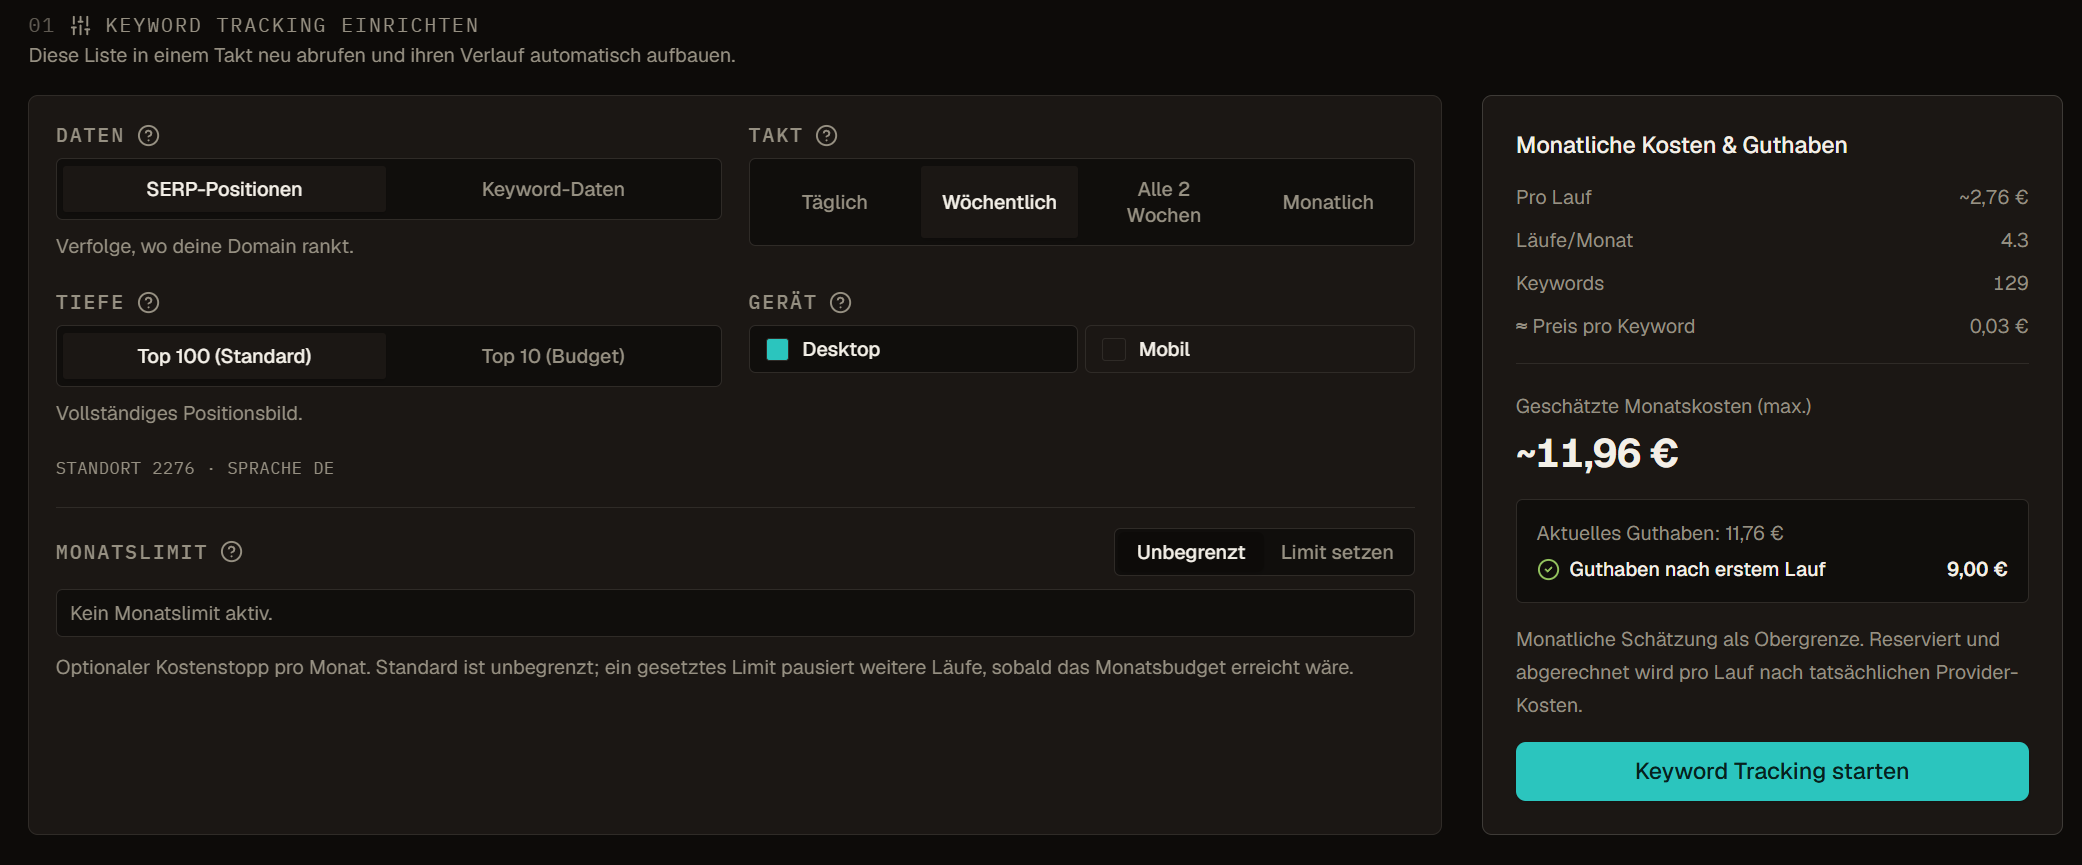
Para SERP tracking elige cohorte, ubicación, idioma, uno o dos dispositivos compatibles, profundidad top 10 o top 100 y frecuencia. Puede ejecutarse a diario, semanalmente, cada dos semanas o al mes. Otro programa de datos de palabras clave puede actualizar paquetes elegidos mensual o trimestralmente.
El formulario estima coste por ejecución y coste mensual medio según cohorte, dispositivos, profundidad, paquetes y frecuencia. Muestra saldo y admite un límite mensual opcional. Sin límite no significa saldo infinito, y una estimación no es el cargo final. Revisa de nuevo tras cambiar el tamaño de lista o añadir otro dispositivo.
- Confirma dominio propio y mercado antes de la primera línea base.
- Elige top 10 si basta la presencia en primera página y top 100 si importa una ausencia más profunda.
- Mide desktop y mobile por separado dentro del programa si ambos contextos cuentan.
- Nombra cohortes de lista por objetivo, mercado y responsabilidad de revisión.
- Fija el límite por el valor esperado de la revisión, no por el máximo del control.
- Crea contextos semejantes de forma consciente, porque los duplicados activos exactos se rechazan.
Antes de repetir las mediciones, revisa los calendarios y costes del seguimiento para el grupo de palabras clave elegido.
Creación, ejecución manual, frecuencia y ciclo de vida son controles distintos
Crear guarda una próxima fecha futura y la interfaz inicia la primera base por la ruta manual. Las siguientes ejecuciones se reclaman según frecuencia. Ejecutar ahora usa la cola normal; un programa SERP puede ofrecer una cola más rápida, estimada aparte, para esa única vez. No comienza nada si está inactivo, ya en marcha, fuera de presupuesto o sin saldo.
Pausar detiene futuras reclamaciones sin destruir el programa. Reanudar lo activa. Terminar lo archiva y lo saca del envío ordinario. Los cambios de cohorte, frecuencia, dispositivos, profundidad, paquetes o límite afectan al futuro, no al alcance inmutable de una ejecución ya reclamada.
Lee el panel de tracking según su modo de agregación
El panel de una lista puede resumir distribución actual, posición media, movimiento e historial disponible. Hasta el umbral histórico compatible, agrega snapshots por palabra clave. Las listas grandes usan una proyección actual desde posiciones desnormalizadas para mantener una lectura acotada sin recorrer todo el historial.
La interfaz señala ese modo de proyección. No lo presentes como un resumen histórico completo. Compara la misma cohorte y contexto, indica cobertura ausente y abre la cronología de la palabra clave cuando un movimiento agregado necesite explicación.
El saldo y el resultado forman parte de la medición
Cada ejecución de pago reclamada reserva el saldo estimado antes del trabajo. Los resultados completados liquidan el coste real y el resto se libera. Un programa con varios dispositivos puede crear ejecuciones hijas dentro de un grupo lógico. Sin datos, parcial, fallida, omitida por saldo y omitida por envío son estados distintos.
El registro conserva cantidades solicitadas y obtenidas, estado final, hora y coste liquidado. Un coste cero puede significar que no se devolvieron datos facturables, no que el programa sea gratis. Fallos o problemas de saldo repetidos pueden pausarlo. Examina el registro en vez de leer la próxima fecha como garantía.
Actividad y el registro demuestran la ejecución, no el clic
Usa Actividad para enriquecimientos SERP y operaciones competitivas, y el registro para programas de tracking. Revisa acción, alcance inicial, inicio, fin, filas solicitadas, correctas, sin datos y fallidas, coste y código visible. Queued o running no es terminado, y partial no es fracaso total.
Si un valor no cambia, confirma que terminó el trabajo correcto y que la fila estaba en su alcance reclamado. Después compara fuente y fecha. Repetir todo antes de esta revisión puede cobrar dos veces, sustituir contexto útil u ocultar el fallo original detrás de otra ejecución.